Все проекты были созданы с использованием Altera DSP Builder Advanced Blockset v12.0 с MathWorks версии R2011b и разработаны с помощью программного обеспечения для проектирования Quartus II v12.0 SP1. Моделирование RTL проводилось с использованием ModelSim 10.1. Проекты были основаны на двух 28-нм FPGA Altera: высокопроизводительной, среднего размера Stratix V 5SGSMD5K2F40C2 и среднебюджетной Arria V 5AGTFD7K3F40I3N. FPGA Stratix V, использованная в этом анализе, включает 345,2 тыс. ALUT, 1590 27x27-битных умножителей переменной точности и 2014 блоков памяти M20K. FPGA Arria V включает в себя 380,4 тыс. АЛУ, 1156 27x27-битных умножителей переменной точности и 2414 блоков памяти M10K. Для оценки использовались аппаратные платформы DSP Development Kit, Stratix V Edition и Arria V FPGA Development Kit. Для оценки удобства использования инструмента в среде Simulink также использовалось программное обеспечение ModelSim для настройки системы.
Для обеих конфигураций на обоих устройствах было выполнено в общей сложности одиннадцать симуляций. Результаты, касающиеся использования ресурсов, производительности и точности, были сохранены для каждой симуляции. В таблице 1 показаны достигнутые показатели использования ресурсов и тактовой частоты для решателей Холецкого и QR для каждой конфигурации. В конструкции решателя Холецкого задан параметр максимального размера матрицы. Во время выполнения могут использоваться матрицы меньшего размера, чем максимальный размер конструкции. Для результатов использования ресурсов, представленных в таблице 1, каждая конфигурация была синтезирована с параметром максимального размера матрицы, равным расчетному размеру матрицы, чтобы получить фактические ресурсы, потребляемые заданным размером матрицы. Ресурсы, используемые блоками стимулов, не включены в общие суммы. Стоит отметить, что ни одна из конфигураций, оцененных в этой статье, не использовала ПЛИС на полную мощность. Для достижения наилучшего значения Fmax в разумные сроки синтеза и размещения/трассировки в Quartus II к каждой конструкции были применены те же ранее установленные параметры оптимизации для повышения скорости. Для примера проектирования Холецкого мы выбрали конфигурацию 6/90x90/45, чтобы запустить Design Space Explorer (DSE) в Quartus II и определить улучшение скорости и времени синтеза по сравнению с методом «нажатия кнопки». В этом случае было зафиксировано улучшение скорости на 12,5%, хотя время выполнения синтеза проекта в Quartus II увеличилось с 2 часов до 7,5 часов.
Использование ресурсов FPGA соответствует прогнозам для оцениваемых проектов. Использование памяти в основном сосредоточено в памяти и пропорционально размеру массива и количеству каналов для многоканальной схемы. Использование блоков DSP линейно возрастает с размером вектора. Для векторного умножителя требуется четыре блока DSP с переменной точностью на каждое 27-битное x 27-битное комплексное умножение с плавающей запятой. Для заданного размера вектора в 60 комплексных значений с плавающей запятой для генератора скалярного произведения требуется 240 блоков DSP.
В таблице 2 представлены результаты работы решателей Холецкого и QR для всех конфигураций. Производительность для каждого случая указана значением Fmax в таблице 1. Пропускная способность рассчитывается путем деления Fmax на количество циклов, затраченных на выполнение прогрессивной подсистемы решателя. Поскольку подсистема обратной подстановки работает параллельно и с меньшей задержкой, чем прогрессивная подсистема, общая пропускная способность остается неизменной. Для повышения производительности многоканального решателя Холецкого этот результат умножается на количество параллельно обрабатываемых каналов (параметр «Размер канала» в таблице 2). Общая задержка для каждого случая рассчитывается путем деления общего количества циклов выполнения прямой и обратной подсистем на Fmax. Выбор размера вектора относительно размера матрицы является компромиссом, зависящим от приложения. Если размер вектора значительно меньше размера матрицы, конструкция будет ресурсоэффективной за счет увеличения задержки, как показано для конфигураций решателя QR с размером матрицы 200x100 и различными размерами векторов.
Улучшения, внесенные многоканальной схемой Холецкого, обсуждались в предыдущей статье BDTI. В одноканальной реализации задержки, такие как те, которые присущи аккумулятору с плавающей запятой, частично маскировались за счет переконфигурации порядка обработки в алгоритме. Как поясняется в ссылке [1], эффективность одноканальной реализации зависела в первую очередь от размеров матриц и векторов. Глядя на столбец производительности в таблице 2, можно увидеть, что многоканальная реализация предлагает значительные преимущества в эффективности обработки, особенно для меньших матриц и векторов. Многоканальный процесс повышает производительность за счет полного маскирования задержек реализации, описанных в разделе 2 данной статьи. Для определенных размеров матриц и векторов многоканальная реализация обеспечит более высокую пиковую производительность, чем ее одноканальный аналог.
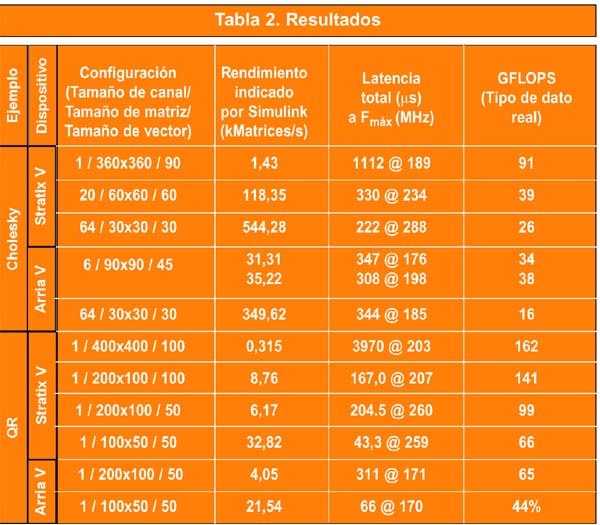 В последнем столбце таблицы указано количество операций с плавающей запятой с действительными числами в секунду в единицах 10⁹ (GFLOPS) для каждой конфигурации. Количество операций, необходимых каждому решателю, зависит от используемого алгоритма декомпозиции. Приведенные данные получены из фактической реализации алгоритмов решателя Холецкого и QR-решателя на комплексных данных с плавающей запятой в двух ПЛИС, использованных для этой оценки. Для решателя Холецкого количество операций с плавающей запятой с действительными числами составляет приблизительно член второго порядка 4n³/³ + 12n², тогда как для решателя QR-решателя используется 8mn² + 6,5m² + mn.
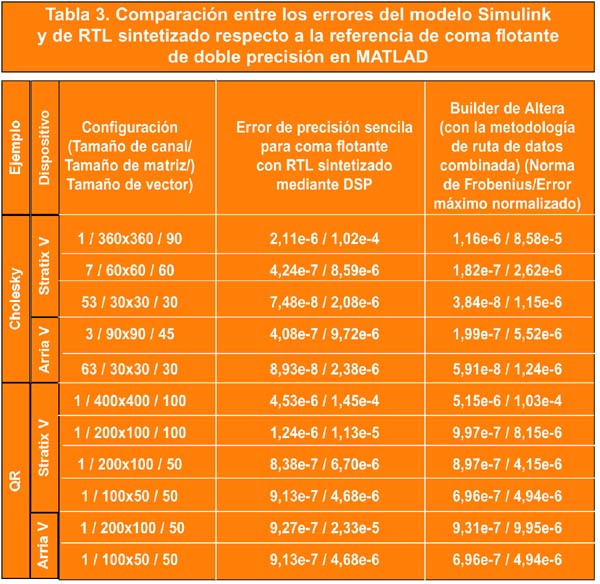
В таблице 3 показана производительность решателей Холецкого и QR-критерия с точки зрения погрешности для моделирования с использованием Simulink и реализации проекта с использованием плат разработки с операциями с плавающей запятой одинарной точности.
Ошибка рассчитывается путем сравнения выходных данных каждой симуляции Simulink и аппаратной платформы с эталонным значением с плавающей запятой двойной точности для векторов решений x, сгенерированных MATLAB. Для многоканального решателя Холецкого для краткости показана только ошибка одного случайно выбранного канала. Хотя ошибка зависит от входных данных, в среднем реализация RTL использует методологию комбинированного пути данных и достигает статистически равной или большей точности, чем реализация стандарта IEEE 754 с одинарной точностью, как показано сравнением нормы Фробениуса в столбцах (4) и (5) таблицы 3.
Мы используем норму Фробениуса для получения меры величины общей ошибки в результирующем векторе, выраженной как:
||E||F = ÷SN = 0 |ei|2
i
Где N — размер вектора, e — вектор разности между наблюдаемым x и его эталоном, сгенерированным MATLAB, а ei — индекс элементов в векторе e. Максимальная нормированная ошибка выражается как:
max (|(xi-obs - xi-ref)/xi-ref|)
i
5. Выводы
В данной статье был оценен новый метод реализации алгоритмов цифровой обработки сигналов с плавающей запятой на ПЛИС с использованием процесса проектирования, предусмотренного набором расширенных блоков DSP Builder от Altera. Этот процесс проектирования включает в себя набор расширенных блоков DSP Builder от Altera, программный инструментарий Quartus II от Altera и симулятор Simulink, а также MATLAB и Simulink от MathWorks. Этот метод позволяет разработчику работать на уровне алгоритмического поведения в среде Simulink. Инструментарий объединяет и интегрирует этапы моделирования и симуляции алгоритмов, генерации RTL, синтеза, размещения и трассировки, а также верификации проекта в среде Simulink. Эта интеграция упрощает разработку и позволяет быстро исследовать пространство проектирования как на алгоритмическом уровне, так и на уровне ПЛИС, сокращая общие трудозатраты на проектирование. После того, как высокоуровневый проект смоделирован и уточнен, его можно синтезировать и перенести на ПЛИС Altera.
 Для проведения этой оценки в качестве примеров проектирования использовались решатели Холецкого и QR-критериев для чисел с плавающей запятой одинарной точности IEEE 754, смоделированные в Simulink с использованием набора блоков Altera DSP Builder Advanced Blockset. Самый большой из оцененных примеров проектирования представлял собой решатель QR-критериев для массива чисел с плавающей запятой 400x400 с размером вектора 100. При работе на частоте 203 МГц этот пример обрабатывает 162 GFLOPS. Значения GFLOPS, показанные в таблице 2, соответствуют фактической реализации алгоритмов Холецкого и QR-критериев для данных с плавающей запятой комплексной точности на двух FPGA. Для корректного сравнения с другими конкурирующими платформами те же алгоритмы должны быть реализованы на этих платформах, и их производительность должна быть измерена. Все показанные результаты были получены с использованием набора блоков Altera DSP Builder Advanced Blockset без ручной оптимизации или базового планирования. Начиная с высокоуровневого блочного проекта в Simulink, инструмент автоматически сегментировал проект, генерировал RTL-код и синтезировал его для достижения приемлемой скорости и эффективности использования ресурсов. Рабочий процесс проектирования с плавающей запятой упрощает реализацию сложных алгоритмов цифровой обработки сигналов с плавающей запятой на ПЛИС за счет объединения инструментов на одной платформе. Эта объединенная методология обработки данных позволяет реализовать сложные пути обработки данных с плавающей запятой с большей производительностью и эффективностью, чем это было возможно ранее.
Новый метод, описанный в этой статье, также требует значительного обучения для использования DSP Builder Advanced Blockset. Это особенно актуально для разработчиков, незнакомых с MATLAB и Simulink. Блочный подход к проектированию может представлять собой первоначальную проблему для традиционных разработчиков аппаратного обеспечения. Кроме того, чтобы использовать преимущества блочного проектирования по сравнению с написанным вручную RTL-кодом, разработчикам необходимо предпринять дополнительные шаги для создания модели Simulink. Например, для тестирования различных размеров матриц и векторов, как показано в двух примерах проектирования, описанных в этой статье, модель Simulink была структурирована таким образом, чтобы включать параметрически управляемое проектирование для изучения различных конфигураций проектирования.
В настоящее время разработчики, использующие расширенный набор блоков DSP Builder, ограничены элементами, предоставляемыми этим набором, для достижения оптимизированной производительности. Элементы стандартного набора блоков DSP Builder не оптимизированы для компилятора с плавающей запятой и не могут быть объединены с расширенным набором блоков на том же иерархическом уровне. Блоки HDL, написанные вручную, могут быть импортированы только в стандартный набор блоков. Кроме того, расширенный набор блоков DSP Builder ориентирован на реализации DSP и может быть ограничен проектами, включающими мощные управляющие и конечные автоматы.
Следующая версия DSP Builder Advanced Blockset, выпуск которой запланирован на конец 2012 года, будет включать расширения для работы с числами с плавающей запятой. Разработчики больше не будут ограничены форматами IEEE 754 с одинарной и двойной точностью, а смогут выбирать из семи различных уровней точности, от 16 до 64 бит (экспонента плюс мантисса). Используя новый блок Enhanced Precision Support в DSP Builder Advanced Blockset, разработчики смогут выбрать ширину данных, которая наилучшим образом подходит для их приложения.
Автор:
Разработано командой Berkeley Design Technology, Inc. Октябрь 2012 г
6. Список литературы
[1] Berkeley Design Technology, Inc., 2011. «Независимый анализ
процесса проектирования цифровой обработки сигналов с плавающей запятой для FPGA от Altera».
Доступно для скачивания по адресу http://www.altera.com/literature/wp/wp-01166-bdti-altera-floating-point-dsp.pdf
[2] С.С. Демирсой, М. Лангхаммер, 2009. «Реализация разложения Холецкого с плавающей запятой в объединенном тракте данных». FPGA'09, февраль 2009 г.