




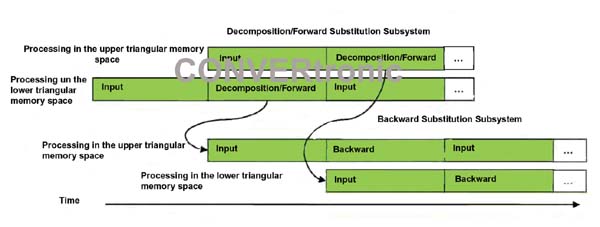
 由于输入矩阵为厄米矩阵,且分解结果生成复共轭转置三角矩阵,因此通过仅加载输入矩阵 A 的下三角部分并在生成下三角矩阵 L 时覆盖该部分,从而优化了内存使用。两个子系统均采用流水线设计,使用输入阶段和处理阶段,使得处理操作在内存的一半区域进行,而另一半区域用于加载新数据。分解阶段和前向代入阶段的输出将作为回代入阶段的输入,如图 2 所示。.
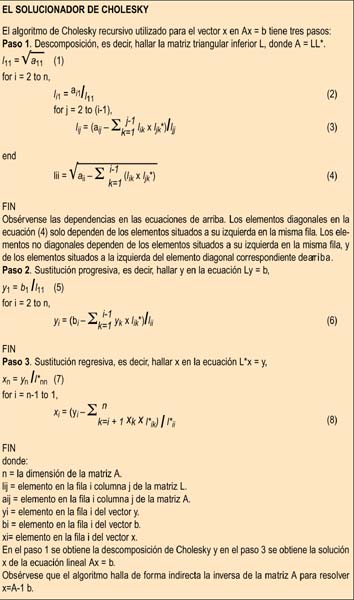
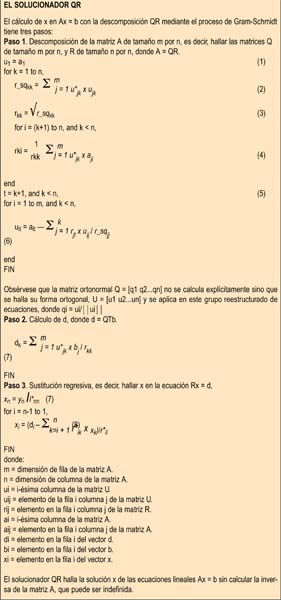
分解的主要部分由复数点积生成器(也称为向量乘法器)组成,它计算方程 (3) 和 (4)。对于 Stratix V 器件,向量大小 (VS) 最大可达 90 个复数数据元素;而对于 Arria V 器件,则实现了最大 45 个复数数据元素的向量大小。向量大小对应于每个时钟周期为点积生成器提供新数据集所需的并行内存读取次数,从而决定了片上双端口内存的宽度和分区。出于实现原因,给定大小的数组的存储空间被划分为 (N/VS) 个向上取整的内存块,其中向上取整 (VS) 是向上取整函数,N 是数组大小。Cholesky
求解器采用多通道设计。最大通道数是一个编译时参数,仅受器件可用内存的限制。内存分区与单通道实现相同,区别在于会创建一定数量的相同结构的副本。
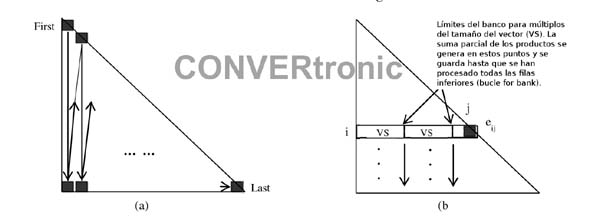
如图 3(a) 所示,分解过程逐元素、逐列进行,从左上角开始,沿垂直方向以之字形路径进行,最终到达矩阵的右下角。首先,计算每一列的对角线元素,然后计算同一列中该对角线元素下方的所有非对角线元素,最后计算右侧下一列的对角线元素。事件和迭代的调度由一个嵌套的四级 for 循环控制。最外层循环处理列;第二层循环处理存储体;第三层循环处理行;最内层循环处理不同的通道。将通道处理放在最内层循环中,有效地将浮点累加器转换为分时累加器,从而更好地隐藏其延迟。DSP Builder 高级模块集中的 NestedLoops 模块将最多三个嵌套循环集成到一个处理模块中,与使用三个独立的 for 循环模块实现类似功能相比,这加快了实现速度并更有效地利用了资源。该模块提取复杂的循环控制信号,减少设计和调试时间,并使循环结构更易于阅读。
 标量积生成器处理矩阵的行,并在单个循环中同时计算公式 (3)、(4) 和 (6) 求和项中向量大小的乘法。标量积生成器的输入端采用循环存储结构,用于处理多个输入矩阵的行。.
对于长度小于向量大小的标量积,未使用的项会被屏蔽,不计入求和。对于长度大于向量大小的标量积,会计算乘积的部分和,并将结果存储在存储体边界内,直到对对应行中给定元素的所有可用存储体求和,得到最终和,如图 3(b) 所示。存储体输出的求和是在单个累加器循环中完成的,该循环使用 DSP Builder 高级模块集中的浮点加法器模块。反馈循环的延迟为 13 个时钟周期。通过交换存储体循环和行循环相对于其传统软件实现顺序的位置,并添加多通道处理,可以隐藏浮点累加器的延迟,从而提高硬件利用率。DSP
Builder 高级模块集会自动计算循环延迟来解决此延迟问题。可以通过选中“循环延迟”模块中的“最小延迟”复选框,配置该工具来计算并使用最小延迟。产生相同延迟的路径可以被分配一个等效组编号,然后该工具会将相同的延迟值分配给该组中的所有成员。虽然本文评估的示例中未使用,但 DSP Builder 高级模块集提供了一个特定于应用程序的浮点累加器,用户可以通过配置最大输入大小和所需的累加精度等参数来定制该累加器,从而优化其速度和资源需求。该模块允许以高时钟频率对单个浮点数流进行单周期采样累加。
 第二个子系统执行回代。该子系统拥有独立的输入和输出存储模块。与 Cholesky 前向替换子系统类似,它也分为输入阶段和处理阶段。由于回代的复杂度约为 N²,而分解的复杂度约为 N³,因此内积运算不使用向量处理。取而代之的是,内积运算使用单个复数乘法器,这足以满足 Cholesky 分解和
 前向分解子系统的步骤要求。
作者:
由伯克利设计技术公司团队撰写。2012年10月
(三月续)








