它们旨在为各种应用场景下的本地智能系统提供强大动力,包括工业机器人和机器、智能相机和检测系统、自动驾驶汽车、零售基础设施以及医疗成像和医疗保健设备。
为了满足各种人工智能应用多样化的部署环境需求,ADLINK 的 MXM 模块采用集成的 NVIDIA RTX PRO™ Blackwell 系列 GPU,在功率和性能配置方面提供了卓越的灵活性。该平台支持 45W 至 150W 的功率预算,使系统设计人员能够根据应用优先级微调性能配置,无论是最大化计算能力还是在严格的散热和功耗限制下运行。
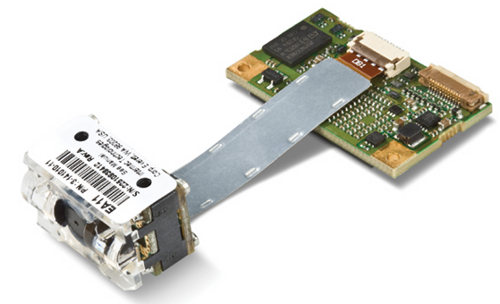
例如,ADLINK EGX-MXM-BW2000 采用 MXM 3.1 A 型封装(82x70mm),可提供高达 100W 的功率,为边缘端紧凑型 AI 性能树立了新标杆,最大限度地提高了空间受限嵌入式系统的计算密度。高端产品 EGX-MXM-BW5000 则搭载了 NVIDIA 多实例 GPU (MIG) 技术,使开发人员能够为并行工作负载划分 GPU 资源,提高隔离性,并在高级边缘 AI 部署中更高效地管理资源。这种强大的组合能够直接在边缘端高效执行大型语言模型 (LLM) 应用、深度学习流水线和其他数据密集型工作负载。.
“多年来,我们与客户紧密合作,在从医疗成像到工业自动化等各种嵌入式应用领域积累了丰富的经验,并见证了人工智能在边缘部署方式的显著转变,”凌华科技边缘可视化事业部总经理陈先生表示,“随着人工智能的普及,客户对GPU性能、内存容量和可靠性提出了更高的要求。我们基于NVIDIA Blackwell架构的MXM模块,兼具卓越的性能、效率和灵活性,能够帮助系统设计人员自信地构建符合自身环境的下一代边缘人工智能解决方案。”
基于 NVIDIA Blackwell 架构的全新 MXM 模块可提供革命性的 AI 推理性能,支持 FP4 精度,吞吐量最高可提升至两倍,同时降低内存带宽需求。NVIDIA 最新的 CUDA 核心、第四代 RT 核心和第五代 Tensor 核心为 AI 推理、计算机视觉和实时数据分析提供强大的 GPU 加速,峰值 FP32 吞吐量可达 9.2 至 49.8 TFLOPS。所有型号均配备新一代 GDDR7 显存,可提供高速传输和低延迟,从而在边缘端持续高效地处理复杂、高负载的工作负载。.
根据配置不同,GDDR7 内存子系统最高支持 24GB 内存容量、256 位内存接口和 896GB/s 带宽,显著提升吞吐量,同时最大限度降低延迟,满足深度学习、高分辨率成像和高级仿真等高要求应用的需求。
所有模块均支持最多四个 DisplayPort 1.4a 输出,可实现工业、交通运输和自动驾驶系统等应用的多显示器可视化。该平台拥有长达 5 年的供货周期和宽广的工作温度范围(标准:0°C 至 55°C,扩展:-40°C 至 85°C),确保在商业和极端工业环境中均能实现长期可靠性、生命周期稳定性和稳定运行。