




 与 Cholesky 迭代法不同,Cholesky 迭代法将公式 (1) 至 (6) 实现为一个嵌套的四级循环,而 QR 求解器则采用单个有限状态机 (FSM) 来循环执行四个主要操作:公式 (2) 中向量模的平方、公式 (4) 中两个向量的点积、公式 (6) 中向量点积的减法以及公式 (7) 中的点积,从而求得向量 d。DSP Builder 高级模块集中的 NestedLoop 模块用于 FSM 的所有阶段,以生成数据路径的所有事件控制信号。.
上述四种操作的公共处理模块是点积生成器。为了提高性能,点积的计算采用向量处理。与 Cholesky 分解类似,向量大小是一个编译时参数。为了在有限状态机 (FSM) 的四种状态中复用该生成器,输入端使用了一个数据多路复用器,并由 FSM 的事件处理程序控制。该多路复用器为 FSM 的每个状态选择正确的点积生成器输入。点积生成器和浮点累加器的细节与 Cholesky 分解类似,因此此处不再赘述。QR
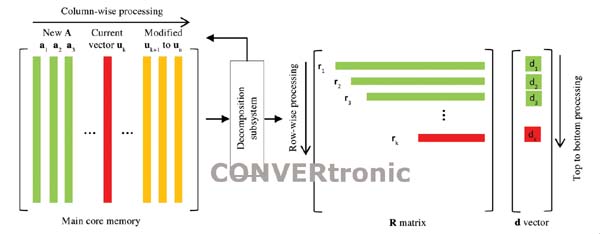
分解所需的内存通过复用最初包含矩阵 A 和输入向量 b 的主内核内存块进行优化。处理在内核内存中按列进行,从左到右。一旦某一列处理完毕且不再需要,就会被新矩阵的对应列覆盖。当旧数组 A 分解时,该内存块的原始内容将被新数组替换,从而保持数组的端到端处理能力,而不会出现停顿。
在有限状态机(FSM)的前两个状态中,矩阵 R 的元素按行方向逐个生成,从每行的对角线元素开始。在 FSM 的减法状态中,主内存中的矩阵 A 的列被递归更新,并替换为部分计算的向量。例如,对于第 k 列,内存中所有第 k+1 列到第 n 列的向量都会被更新,方法是从第 k+1 列到第 n 列的每一列中减去缩放后的向量。这个过程递归地计算向量 uk+1 到 un,是公式 (6) 更高效的硬件实现版本。在 FSM 的第四个状态中,按列方向处理,每个新计算的 uk 都乘以输入向量 b,生成列向量 d 的一个元素 dk。矩阵 Q 本身并没有被显式生成,但它的正交列 uk 被生成并在 FSM 的后续阶段中使用。在下一个 FSM 周期中,这些列会被覆盖到新矩阵的对应列 ak 中。图 5 显示了 QR 分解子系统的内存组织和处理顺序。.
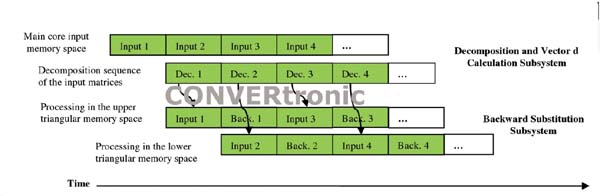
第一个子系统的输出是矩阵 R 和列向量 d。矩阵 R 是一个上三角矩阵,如公式 (3) 和 (4) 所示,从左到右按列生成。这里采用了乒乓三角记忆结构。当回代子系统处理上三角部分时,分解子系统填充下三角部分,反之亦然。列向量 d 添加到矩阵 R 中,并从上到下按列生成。回代的输出是线性方程组 Ax = b 的解向量 x。.
QR求解器可以采用类似于Cholesky求解器的多通道格式实现,从而提高资源利用率、降低延迟并提升设计性能。性能提升主要归功于浮点累加器延迟的有效降低。.
3. 设计流程和工具包
评估方法
在本次评估中,Altera 向 BDTI 提供了使用 DSP Builder 高级模块集创建的 Cholesky 和 QR 求解器的实现。Altera 还为 BDTI 工程师提供了一台预装了 Altera 工具和 MathWorks 的 PC。BDTI 工程师随后在 Simulink 环境中检查、仿真和综合了 Altera 的设计。综合后的设计被应用于两个不同的器件:Stratix V 和 Arria V FPGA。在此过程中,BDTI 评估了 Altera 的设计流程以及两个示例设计的性能。
由于本次评估使用的测试卡无法生成示例设计的激励信号,因此每个设计都包含一个激励生成模块,该模块使用 DSP Builder 高级模块集模块实现,并与被测应用程序的设计一起编译。为了最大限度地减少激励模块对测试设计性能和 FPGA 资源使用的影响,激励模块使用一组更小的随机数据动态生成矩阵 A。这个小型数据集使用 MATLAB 中的 m 文件脚本生成,加载到激励模块的内存中,并与设计一起编译。这些 MATLAB 脚本使用与测试设计中的激励模块相同的算法,为解向量 x 生成双精度浮点参考数据,以便测量输入到 FPGA 的 Simulink 模型和设计的误差水平。在 Cholesky 分解设计中,该算法保证矩阵 A 具有正 Hermitian 定义,而使用 QR 求解器的设计则保证生成条件良好的矩阵 A。Cholesky 求解器设计实现了四种向量、矩阵和通道大小配置:三种在 Stratix V FPGA 上实现,两种在 Arria V 器件上实现,其中一种配置在两者上通用。对于 QR 求解器设计,四种配置在 Stratix V FPGA 上实现,其中两种配置也在 Arria V 器件上实现。所有配置均从 FPGA 资源利用率、最大时钟频率、性能和功能正确性等方面进行了评估。 FPGA 设计约束(例如时钟频率、器件选择和速度级别)在 Simulink 环境中指定。
 性能和功能分别在Simulink模型和硬件平台层面进行了评估。两种设计的Simulink模型均进行了插值,以可视化正向过程以及正向和反向处理周期的总数,而Quartus II软件则提供了每种配置所能达到的最大频率(Fmax)。随后,将每种配置下载到硬件平台,将其工作频率设置为Fmax,并启动该过程。捕获每种配置下每个求解器的解向量(x),并将其与MATLAB中生成的相应双精度浮点参考值进行比较。.
仿真后脚本计算 Simulink IEEE 754 单精度浮点输出与 MATLAB 中生成的双精度浮点参考向量之间的差异。类似地,该脚本还计算从硬件仿真中捕获的输出与 MATLAB 中生成的双精度浮点参考值之间的差异。.
Simulink 工具包的评估
基于 MATLAB 环境,因此必须使用 MATLAB 环境。在 Simulink 环境中,评估的设计使用了 DSP Builder 高级模块集中的模块,该模块集独立于 DSP Builder 标准库。DSP Builder 高级模块集面向基于模块的 DSP 算法和数据通路实现,其抽象级别高于包含更通用和基本模块的 DSP Builder 标准库。DSP Builder 高级模块集库包含 50 多个常用的三角函数、算术函数和布尔函数,以及用于快速傅里叶变换 (FFT) 和 FIR 滤波器的更复杂的功能模块。Quartus II 12.0 版本新增的显著功能包括低延迟平方根、嵌套 for 循环和可自定义的浮点累加器模块。标准模块集和 DSP Builder 高级模块集的元素不能在同一层级的数据通路结构中混合使用。只有 DSP Builder 高级模块集中的模块支持浮点编译器。标准模块集中的模块并未针对浮点处理进行优化。此外,虽然标准模块集支持手动编写的 HDL 代码导入,但 DSP Builder 高级模块集不支持此功能,因为该工具无法执行 HDL 级别的实现。通常,基于模块的设计输入方法非常适合 DSP 算法;然而,由于模块库中不提供诸如 `case` 或 `switch` 之类的结构,因此对于控制密集型设计以及涉及状态机的设计,基于文本的方法更为直观。
使用 DSP Builder Advanced Blockset 运行仿真程序,会编译 Simulink 模型,生成 Altera Quartus II 软件环境所需的 HDL 代码和约束条件,生成 ModelSim 环境所需的测试平台和脚本文件,并对 Simulink 模型进行仿真。使用 Intel Xeon W3550 PC,不同配置的仿真时间从 3 分钟到 28 分钟不等,具体取决于阵列大小。Simulink 仿真无需编译 Quartus II 软件即可提供详细的资源利用率估算,从而帮助设计人员快速确定所需的器件尺寸。使用硬件开发套件 (HDK) 时,用户必须根据电路板布局提供输出引脚分配。用户可以在 Quartus II 软件项目文件夹中提供的 .qsf 文件中应用输出引脚约束,也可以使用 Quartus II 软件的引脚配置功能从一开始就分配和管理输出引脚。.
为了评估算法的易用性以及相应硬件描述语言(HDL)的生成,我们对模型进行了测试。在激励模块和仿真执行过程中,我们更改了点积大小、矩阵大小和数据类型等输入参数。在所有情况下,我们都在几分钟内生成了正确的RTL代码,并且仿真结果与MATLAB参考代码相符。.
所有配置均使用 Quartus II 设计软件进行综合,该软件可直接从 Simulink 环境启动。设计人员可以使用 Quartus II 的按钮模式,采用默认或用户选择的优化参数,也可以使用设计空间浏览器 (DSE) 工具。DSE 是 Quartus II 的一部分,它会自动执行多次布线,每次使用不同的种子。系统会保存时钟频率最佳的布线路径。这是一个自动化过程,无需用户干预,但耗时比按钮模式长得多。使用 Quartus II 的按钮模式耗时 1 到 6.5 小时,具体时间取决于设计规模。.
DSP Builder 高级模块集设计流程所采用的高度抽象化加速了算法空间的探索和仿真周期,从而缩短了实现最终优化设计所需的总时间。然而,这种优势并非 Simulink 本身固有的,例如数据类型传播等功能。为了充分利用基于模块的设计方法相比于手写 RTL 代码所提供的探索设计空间的优势,设计人员在创建 Simulink 模型时必须采取额外的步骤。具体而言,模型必须能够根据参数进行算法空间的探索。本文分析的示例模型均已实现,允许测试不同的矩阵大小、向量大小以及(对于 Cholesky 求解器)并行通道数。一旦创建了包含这种灵活性的模型,就可以通过改变这些参数来探索各种设计配置的性能和资源使用情况。此外,为了实现良好的性能和资源利用率,还需要了解硬件设计,例如本文第 2 节讨论的浮点累加器。.
DSP Builder 高级模块集设计工作流程的培训包括 Altera 提供的 4 小时讲座和约 10 小时的在线研讨会和演示。此外,BDTI 还花费了约 90 小时进行实践操作,学习该工具及其两种模型。熟练掌握该工具包所需的时间和精力取决于设计人员的技能和先前的知识。
经验丰富的 Simulink 模块式设计和硬件设计工程师可能会发现 DSP Builder 高级模块集方法高效易用。对于几乎或完全不了解 MATLAB 和 Simulink 的 FPGA 设计人员来说,更高抽象层次的设计可能代表着一种新的思维方式,因此最初会面临挑战,这可能会影响学习曲线。一旦熟悉了该方法,设计人员就能实现比使用 HDL 快得多的设计周期。他们可以专注于算法的实现,而无需担心诸如分段之类的硬件设计细节。由于大部分仿真和功能验证都在 Simulink 环境中执行,因此设计和验证时间显著缩短。然后可以将 Simulink 构建的 RTL 输出导入 ModelSim 软件进行完整的功能仿真。
对于具备系统级设计知识但硬件设计经验较少的工程师而言,该工具包的学习曲线可能较为平缓。虽然它将硬件编译、综合、布线和自动脚本生成功能集成到 Simulink 环境中,并抽象化了数据分割和信号矢量化等众多复杂的设计概念,但要完成实现,仍然需要一定的硬件知识。.
(四月续)
作者:
由伯克利设计技术公司团队撰写。2012年10月








