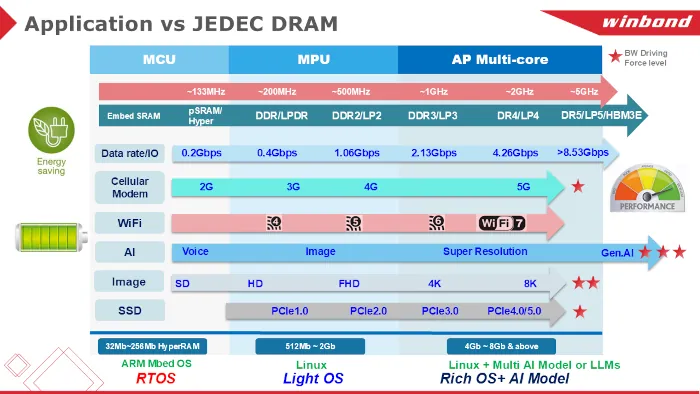
为了满足这些新需求,业界正在开发能够最大限度提高带宽、最大限度降低延迟并提升能效的新一代内存架构。DRAM、LPDDR 和专用内存解决方案的技术进步正在重新定义计算性能,而 AI 优化内存则在提升效率和可扩展性方面发挥着关键作用。
华邦电子株式会社的 CUBE 内存正是这一进步的典范,它提供了一种高带宽、低功耗的解决方案,旨在支持 AI 驱动的工作负载。本文将探讨内存技术的最新发展、AI 应用日益增长的影响以及华邦电子为应对不断变化的市场需求而采取的战略。
先进的内存架构和性能扩展:
内存技术不断发展,以满足人工智能 (AI)、人工智能物联网 (AIoT) 和 5G 系统对性能的严苛要求。
DDR5
和 HBM3E
等标准的采用,整个行业正在经历一场重大变革
。这些标准提供更高的带宽和更佳的能效。DDR5
的单引脚数据速率高达 6.4 Gbps,每个模块可提供 51.2 GB/s 的带宽,几乎是 DDR4 性能的两倍,同时将电压从 1.2 V 降低到 1.1 V,从而提高了能效。
另一方面,HBM3E 的单堆栈带宽超过 1.2 TB/s,使其成为训练数据密集型 AI 模型的理想解决方案,但由于其高功耗,并不适用于移动或边缘设备。
预计到 2026 年,LPDDR6 的带宽将超过 150 GB/s,这表明低功耗 DRAM 正在朝着更高的性能和能效水平发展,以满足 AI 智能手机和集成 AI 加速器等设备的需求。
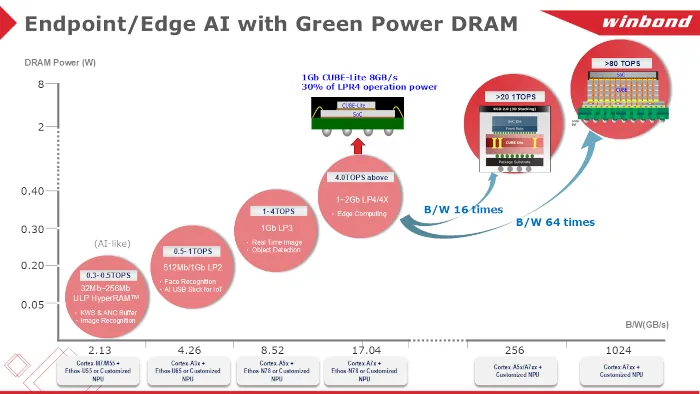
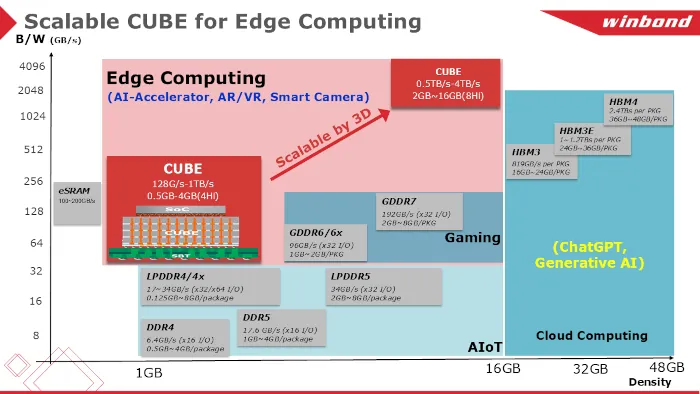
在此背景下,华邦电子正积极开发针对功耗敏感型应用优化的低容量DDR5和LPDDR4解决方案,同时也在推进其CUBE内存的研发。CUBE内存能够在显著降低散热的同时,实现超过1TB/s的带宽。
基于单一晶格尺寸,CUBE内存计划单堆叠容量最高可达8GB,并可实现更高配置,例如4Hi WoW。CUBE内存的容量密度可超过70GB,带宽最高可达40TB/s,使其成为边缘AI计算领域传统DRAM架构的先进替代方案。
CUBE - Lite子系列提供8至16 GB/s的带宽(相当于LPDDR4x x16/x32),而功耗仅为LPDDR4x的30%。
-Lite:面向低功耗AI设备的高效内存。CUBE
其优势之一在于无需LPDDR4 PHY,SoC只需集成CUBE-Lite控制器即可实现与LPDDR4x全速运行性能相当的性能。
这带来了几个好处:
它消除了高昂的 PHY 许可费用,
允许使用成熟的制造节点,例如 28 纳米甚至 40 纳米,
并达到与 12 纳米节点相当的性能水平。
这种架构尤其适用于:
集成NPU的AI-SoC或AI-MCU,以及
电池供电的TinyML设备。
结合Micro Linux操作系统和AI模型的执行,它可以应用于低功耗边缘AI场景,例如:
AI IP摄像头、
智能眼镜和
可穿戴设备。
这有助于优化系统功耗并减小芯片面积。
生成式人工智能的内存瓶颈:
生成式人工智能模型的指数级增长给内存带宽和延迟带来了新的限制。
人工智能工作负载,尤其是基于Transformer架构的工作负载,需要强大的计算能力和高速数据访问。
例如,在INT8模式下运行LLaMA 2 7B至少需要7 GB的DRAM,在INT4模式下则需要3.5 GB,这凸显了当前移动内存的局限性。
使用LPDDR5(68 GB/s)的人工智能智能手机面临着严重的瓶颈,推动了向LPDDR6的过渡。
然而,在LPDDR6技术普及之前,需要一些过渡方案来缩小带宽差距。
在机器人、
自动驾驶汽车和
智能传感器
等边缘应用中
能效和散热方面的限制也日益凸显。
尽管 JEDEC 标准正朝着 DDR6 和 HBM4 方向发展,但像 CUBE 这样的定制架构提供了可扩展的高性能替代方案,满足 AI SoC 的需求。CUBE
能够在功耗低于 10W 的情况下提供 HBM 级别的带宽,使其成为边缘 AI 推理的可行选择。散热管理和能效:
在终端设备上运行大规模 AI 模型给散热管理和功耗带来了巨大挑战。AI
工作负载会消耗大量电力并产生热量,这会影响系统稳定性。
关键策略包括:
- 设备内存扩展:
移动设备需要集成更大的内存容量,以减少对云的依赖并降低延迟。-
HBM3E 与 CUBE:
虽然 HBM3E 性能出色,但其单堆叠功耗可能超过 30W,因此不适用于移动设备。CUBE
内存可用作 LLC(末级缓存),从而减少对片上 SDRAM 的依赖。-
散热优化:
由于每个芯片的热负载超过 15W,因此优化电源分配和散热至关重要。
采用 TSV(硅通孔)封装的定制 DRAM 解决方案(例如 CUBE 中使用的封装)可提高能源效率。
DDR5 和 DDR6:利用人工智能加速计算
DDR5 和 DDR6 的演进标志着人工智能系统架构的一个转折点。DDR5
采用
集成于芯片中的
8 组
提高了数据完整性和效率,使其成为人工智能 PC 和高性能笔记本电脑的理想选择。DDR5
单条内存最高速度可达 51.2 GB/s,支持
实时人工智能推理
高级多任务处理
高速数据处理。
单条
内存速度有望
功耗降低 20%,
并优化了对人工智能加速器的支持。
华邦电子的AI内存战略:
华邦电子致力于推动面向AI工作负载的定制DRAM架构创新。
主要举措包括:
- CUBE作为AI优化内存:
得益于TSV互连技术,CUBE兼具高带宽和低功耗,是移动和边缘AI SoC的理想之选。-
与OSAT合作伙伴的合作:
公司正与半导体封装测试 (OSAT)供应商合作,以提升与下一代AI硬件的集成度。-
面向未来的DRAM创新:
其发展路线图包括:
AI优化DRAM、
新型专用缓存和
优化的LPDDR架构。
这些技术将使华邦电子能够满足高性能计算(HPC)、机器人和实时处理领域日益增长的AI需求。
结论:
人工智能驱动的工作负载、性能扩展的限制以及对节能内存的需求正在改变内存市场格局。
生成式人工智能正在加速对高速、低延迟内存架构的需求,推动DRAM和定制内存解决方案的创新。
华邦电子在CUBE和DDR5/LPDDR等技术领域的领先地位使其成为下一代人工智能计算的关键参与者。
随着人工智能模型变得日益复杂,对优化高效的内存架构的需求将变得愈发迫切。华邦电子致力于技术创新,旨在弥合高性能计算与可持续、可扩展的内存解决方案之间的差距。