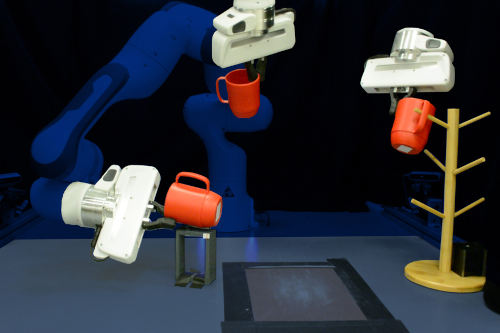
Mas uma nova técnica desenvolvida por investigadores do MIT exigiria apenas algumas demonstrações humanas para reprogramar o robô. Este método de aprendizagem automática permite que o robô pegue e coloque objetos invisíveis em posições aleatórias que nunca encontrou antes. Em 10 ou 15 minutos, o robô estará pronto para executar uma nova tarefa de pegar e colocar.
A técnica utiliza uma rede neural especificamente concebida para reconstruir as formas dos objetos 3D. Com apenas algumas demonstrações, o sistema utiliza o que a rede neural aprendeu sobre geometria 3D para compreender novos objetos semelhantes aos das demonstrações.
Em simulações e utilizando um braço robótico real, os investigadores demonstram que o seu sistema consegue manipular eficazmente chávenas, taças e garrafas nunca antes vistas, dispostas em posições aleatórias, utilizando apenas 10 demonstrações para ensinar o robô.
"A nossa principal contribuição é a capacidade geral de fornecer, de forma mais eficiente, novas competências a robôs que precisam de operar em ambientes menos estruturados, onde pode haver muita variabilidade. O conceito de generalização por construção é uma capacidade fascinante, porque este problema é, muitas vezes, muito mais difícil", afirma Anthony Simeonov, estudante de pós-graduação em engenharia elétrica e de computação (EECS) e coautor do artigo.
Simeonov é coautor do artigo com Yilun Du, estudante de pós-graduação em Engenharia Eletrotécnica e Ciência da Computação (EECS); Andrea Tagliasacchi, investigadora científica do Google Brain; Joshua B. Tenenbaum, professor catedrático da Cátedra Paul E. Newton de Ciência Cognitiva e Computação no Departamento de Ciências Cognitivas e Cerebrais e membro do Laboratório de Ciência da Computação e Inteligência Artificial (CSAIL); Alberto Rodriguez, professor associado da turma de 1957 do Departamento de Engenharia Mecânica; e os autores principais Pulkit Agrawal, professor no CSAIL, e Vincent Sitzmann, futuro professor assistente em EECS. A investigação será apresentada na Conferência Internacional de Robótica e Automação.
Geometria de aderência
Um robô pode ser treinado para apanhar um objeto específico, mas se esse objeto estiver deitado de lado (talvez tenha caído), o robô perceciona-o como um cenário completamente novo. Esta é uma das razões pelas quais os sistemas de aprendizagem automática têm tanta dificuldade em generalizar para novas orientações de objetos.
Para superar este desafio, os investigadores criaram um novo tipo de modelo de rede neural, um campo descritor neural (NDF, na sigla em inglês), que aprende a geometria 3D de uma classe de objetos. O modelo calcula a representação geométrica de um item específico utilizando uma nuvem de pontos 3D, que é um conjunto de pontos de dados ou coordenadas em três dimensões. Os pontos de dados podem ser obtidos a partir de uma câmara de profundidade que fornece informações sobre a distância entre o objeto e um ponto de vista. Embora a rede tenha sido treinada em simulação com um grande conjunto de dados de formas 3D sintéticas, pode ser aplicada diretamente a objetos do mundo real.
A equipa projetou o NDF com uma propriedade conhecida como equidistância. Com esta propriedade, se o modelo receber uma imagem de uma chávena na vertical e, de seguida, uma imagem da mesma chávena de lado, compreenderá que a segunda chávena é o mesmo objeto, apenas rodado.
"Esta ambiguidade é o que nos permite lidar de forma muito mais eficaz com os casos em que o objeto observado se encontra numa orientação arbitrária", afirma Simeonov.
À medida que o NDF aprende a reconstruir as formas de objetos semelhantes, aprende também a associar partes relacionadas desses objetos. Por exemplo, ele aprende que as pegas das chávenas são semelhantes, mesmo que algumas chávenas sejam mais altas ou mais largas do que outras, ou tenham pegas mais curtas ou mais compridas.
"Se quisesse fazer isto com outra abordagem, teria de rotular manualmente todas as partes. Em vez disso, o nosso método descobre automaticamente essas partes a partir da reconstrução da forma", diz Du.
Os investigadores utilizam este modelo NDF treinado para ensinar uma nova habilidade a um robô com apenas alguns exemplos físicos. Movem a mão do robô sobre a parte de um objeto que querem que ele agarre, como a borda de uma tigela ou a pega de uma chávena, e registam a localização das pontas dos dedos.
Como o NDF aprendeu muito sobre geometria 3D e como reconstruir formas, consegue deduzir a estrutura de uma nova forma, permitindo que o sistema transfira as provas para novos objetos em poses arbitrárias, explica Du.
Escolha um vencedor
Testaram o seu modelo em simulações e num braço robótico real, usando copos, taças e garrafas como objetos. O método alcançou uma taxa de sucesso de 85% em tarefas que envolviam pegar e colocar objetos novos em novas orientações, enquanto o melhor método de referência obteve apenas 45% de sucesso. O sucesso é definido como agarrar um novo objeto e colocá-lo num local específico, como pendurar copos numa prateleira.
Muitas linhas de base utilizam informação de imagem 2D em vez de geometria 3D, o que dificulta a incorporação da equidistância por estes métodos. Esta é uma das razões pelas quais a técnica NDF funcionou muito melhor.
Embora os investigadores estejam satisfeitos com o desempenho, o método funciona apenas para a categoria específica de objetos com que foi treinado. Um robô treinado para apanhar chávenas não conseguirá apanhar caixas ou auscultadores, pois estes objetos têm características geométricas muito diferentes das da rede treinada.
"No futuro, o ideal seria alargá-lo a muitas categorias ou abandonar completamente a noção de categoria", diz Simeonov.
Planeiam também adaptar o sistema a objetos não rígidos e, a longo prazo, permitir que o sistema execute tarefas de seleção e posicionamento quando a área alvo muda.
Este trabalho foi financiado, em parte, pela Agência de Projetos de Investigação Avançada de Defesa (DARPA), pela Agência de Ciência e Tecnologia de Defesa de Singapura e pela Fundação Nacional de Ciência (NSF).
###
Escrito por Adam Zewe, MIT News Office


 Asparagus picking-1-w.jpg)