




 Ao contrário do método de Cholesky, onde as equações (1) a (6) são implementadas como um único ciclo aninhado de quatro níveis, o solucionador QR emprega uma única máquina de estados finitos (MEF) para percorrer as quatro operações principais: encontrar o quadrado da magnitude de um vetor na equação (2), o produto escalar de dois vetores na equação (4), a subtração do produto escalar de um vetor na equação (6) e o produto escalar na equação (7) para encontrar o vetor d. O bloco NestedLoop do DSP Builder Advanced Blockset é utilizado em todas as fases do MEF para gerar todos os sinais de controlo de eventos para o caminho de dados.
O bloco de processamento comum nas quatro operações acima referidas é o gerador de produto escalar. Para melhorar o desempenho, é utilizado o processamento vetorial para calcular o produto escalar. À semelhança do projeto de Cholesky, o tamanho do vetor é um parâmetro de tempo de compilação. Para reutilizar este gerador nos quatro estados da máquina de estados finitos (MEF), é utilizado um multiplexador de dados na entrada e controlado pelo manipulador de eventos da MEF. O multiplexador seleciona as entradas corretas para o gerador de produto escalar em cada estado do MEF. Os detalhes do gerador de produto escalar e do acumulador de ponto flutuante são semelhantes aos do projecto de Cholesky e, por isso, não serão aqui incluídos.
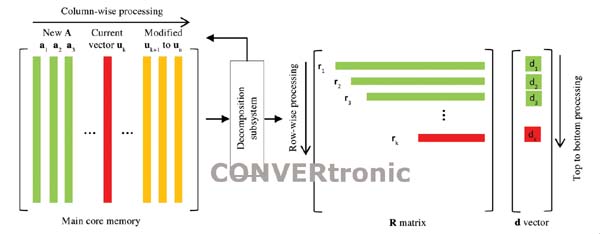
A memória necessária para a decomposição QR é otimizada através da reutilização do bloco de memória principal do kernel, que contém inicialmente a matriz A e o vetor de entrada b. O processamento ocorre coluna a coluna, da esquerda para a direita, na memória do kernel. Assim que uma coluna é concluída e já não é necessária, é sobrescrita com a coluna correspondente de uma nova matriz. Quando o array antigo A se decompõe, o conteúdo original desse bloco de memória é substituído por um novo array, mantendo assim a capacidade de processamento fim-a-fim do array sem interrupções.
Nos dois primeiros estados da FSM, os elementos da matriz R são gerados elemento a elemento na direção das linhas, começando pelo elemento diagonal de cada linha. No estado de subtração da FSM, as colunas da matriz A na memória principal são atualizadas recursivamente e substituídas pelos vetores parcialmente calculados. Por exemplo, na coluna k, todas as colunas k+1 a n são actualizadas na memória subtraindo a versão escalonada de a cada uma das colunas k+1 a n. Este processo calcula recursivamente os vetores uk+1 a un e é uma versão mais eficiente da equação (6) para implementação em hardware. Processando na direção das colunas no quarto estado da FSM, cada uk recém-calculado é multiplicado pelo vetor de entrada b para gerar um único elemento dk do vetor coluna d. A matriz Q não é gerada explicitamente, mas as suas colunas ortogonais, uk, são geradas e utilizadas em fases posteriores da FSM. Estas colunas são depois sobrescritas na coluna correspondente, ak, da nova matriz no próximo ciclo da FSM. A Figura 5 mostra a organização da memória e a sequência de processamento do subsistema de decomposição QR.
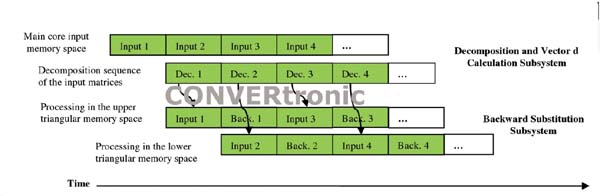
As saídas do primeiro subsistema são a matriz R e o vetor coluna d. A matriz R é uma matriz triangular superior e é gerada coluna a coluna da esquerda para a direita, como indicado pelas equações (3) e (4). É aplicada uma estrutura de memória triangular ping-pong. Enquanto a secção triangular superior está a ser processada no subsistema de retrosubstituição, a secção triangular inferior é preenchida pelo subsistema de decomposição, e vice-versa. O vetor coluna d é adicionado à matriz R e é gerado coluna a coluna de cima para baixo. A saída da retrosubstituição é o vetor solução x das equações lineares Ax = b.
O solucionador QR pode ser implementado num formato multicanal semelhante ao solucionador de Cholesky para melhorar a utilização, reduzir a latência e aumentar o desempenho do projeto. A melhoria do desempenho deve-se principalmente à redução efetiva da latência do acumulador de ponto flutuante.
3. Fluxo de Projeto e
Metodologia de Avaliação
Para esta avaliação, a Altera forneceu à BDTI implementações dos solucionadores de Cholesky e QR criadas utilizando o DSP Builder Advanced Blockset. A Altera forneceu aos engenheiros da BDTI um PC com as ferramentas da Altera e do MathWorks pré-instaladas. Os engenheiros da BDTI examinaram, simularam e sintetizaram os projetos da Altera no ambiente Simulink. Os projetos sintetizados foram então aplicados a dois dispositivos distintos: os FPGAs Stratix V e Arria V. Durante este processo, a BDTI avaliou o fluxo de projeto da Altera e o desempenho dos dois projetos de exemplo.
Uma vez que as placas utilizadas para esta avaliação não conseguiam gerar os estímulos para os projetos de exemplo, cada projeto contém um bloco de geração de estímulos implementado utilizando blocos do DSP Builder Advanced Blockset e compilado com o projeto da aplicação em teste. Para minimizar o impacto do bloco de estímulos no desempenho do projeto de teste e na utilização dos recursos do FPGA, a matriz A é gerada dinamicamente pelo bloco de estímulos a partir de um conjunto muito mais pequeno de dados aleatórios. Este pequeno conjunto de dados é gerado através de scripts em formato m no MATLAB, carregados para a memória do bloco de estímulos e compilados com o projeto. Estes scripts MATLAB utilizam o mesmo algoritmo do bloco de estímulo no projeto de teste para gerar dados de referência de ponto flutuante de dupla precisão para o vetor de solução x, de forma a medir o nível de erro dos modelos e projetos Simulink inseridos nos FPGAs. No projeto de Cholesky, este algoritmo garante uma definição hermitiana positiva para a matriz A, enquanto o projeto que utiliza o solver QR garante a criação de uma matriz A bem condicionada. Foram implementadas quatro configurações de tamanho de vetor, matriz e canal para o projeto do solver de Cholesky: três no FPGA Stratix V e duas no dispositivo Arria V, com uma configuração comum a ambos. Para o projeto do solucionador QR, foram implementadas quatro configurações no FPGA Stratix V, e duas delas foram também implementadas no dispositivo Arria V. Todas as configurações foram avaliadas quanto à utilização dos recursos do FPGA, frequência máxima do relógio, desempenho e correção funcional. As restrições de design do FPGA, como a frequência de relógio, a seleção de dispositivos e o nível de velocidade, são especificadas no ambiente Simulink.
 O desempenho e as capacidades foram avaliados tanto ao nível do modelo Simulink como ao nível da plataforma de hardware. O modelo Simulink para ambos os projetos foi instrumentado para visualizar o processo direto e o número total de ciclos de processamento direto e inverso, enquanto o software Quartus II forneceu a frequência máxima (Fmax) alcançada para cada configuração. Cada configuração foi então transferida para a plataforma de hardware, a sua frequência de operação foi definida como Fmax e o processo foi iniciado. Os vetores de solução (x) de cada solucionador para cada configuração foram capturados e comparados com as correspondentes referências de ponto flutuante de dupla precisão geradas no MATLAB.
O script pós-simulação calcula a diferença entre a saída de ponto flutuante de precisão simples IEEE 754 do Simulink e os vetores de referência de ponto flutuante de precisão dupla gerados no MATLAB. Da mesma forma, o script calcula a diferença entre a saída capturada das simulações de hardware e as referências de ponto flutuante de precisão dupla geradas no MATLAB.
A avaliação do kit de ferramentas Simulink
é baseada no ambiente MATLAB e, por isso, requer-o. No ambiente Simulink, os projetos avaliados utilizam blocos do DSP Builder Advanced Blockset, que é um conjunto de blocos separado da biblioteca padrão do DSP Builder. O DSP Builder Advanced Blockset está orientado para a implementação baseada em blocos de algoritmos DSP e caminhos de dados, e utiliza um nível de abstração mais elevado do que a biblioteca padrão do DSP Builder, que inclui blocos mais gerais e elementares. A biblioteca DSP Builder Advanced Blockset contém mais de 50 funções trigonométricas, aritméticas e booleanas comuns, para além dos blocos funcionais mais complexos para a Transformada Rápida de Fourier (FFT) e filtros FIR. Adições notáveis à versão 12.0 do Quartus II incluem os seus blocos de raiz quadrada de baixa latência, o ciclo for aninhado e o acumulador de ponto flutuante personalizável. Os elementos do Standard Blockset e do DSP Builder Advanced Blockset não podem ser misturados numa estrutura de caminho de dados no mesmo nível de hierarquia; apenas os blocos do DSP Builder Advanced Blockset suportam o compilador de ponto flutuante. Os blocos do Conjunto de Blocos Padrão não estão otimizados para o processamento em ponto flutuante. Além disso, embora a importação de código HDL esteja disponível para o Conjunto de Blocos Padrão, não está disponível para o Conjunto de Blocos Avançado do DSP Builder, uma vez que a ferramenta não consegue realizar implementações a nível HDL. Em geral, a abordagem baseada em blocos para a entrada de projetos é adequada para algoritmos DSP; no entanto, como construções como `case` ou `switch` não estão disponíveis na biblioteca de blocos, uma abordagem baseada em texto é mais intuitiva para projetos com uso intensivo de controlo e aqueles que envolvem máquinas de estados.
A execução de uma simulação com o DSP Builder Advanced Blockset compila o modelo Simulink, gera código HDL e restrições para o ambiente de software Quartus II da Altera, gera um ambiente de teste e ficheiros de script para o ambiente ModelSim e simula o modelo Simulink. Os tempos de simulação para várias configurações variaram entre 3 a 28 minutos, dependendo do tamanho do array, utilizando um PC com um processador Intel Xeon W3550. A simulação Simulink fornece estimativas detalhadas da utilização de recursos sem exigir a compilação do software Quartus II, ajudando assim o projetista a determinar rapidamente o tamanho necessário do dispositivo. Ao utilizar um kit de desenvolvimento de hardware (HDK), o utilizador deve fornecer a atribuição dos pinos de saída com base no layout da placa. O utilizador pode aplicar restrições de pinos de saída no ficheiro . qsf fornecido na pasta do projeto do software Quartus II ou utilizar a configuração de pinos do software Quartus II para atribuir e gerir os pinos de saída desde o início.
Foram realizados testes no modelo para avaliar a facilidade de exploração do algoritmo e a geração do HDL correspondente. Os parâmetros de entrada, como o tamanho do produto escalar, o tamanho da matriz e o tipo de dados, foram alterados no bloco de estímulos e durante a execução da simulação. Em todos os casos, o código RTL correto foi gerado em poucos minutos e os resultados da simulação corresponderam à referência do MATLAB.
Todas as configurações foram sintetizadas utilizando o software de projeto Quartus II, que pode ser executado diretamente a partir do ambiente Simulink. O projetista pode utilizar o Quartus II no modo de execução manual com parâmetros de otimização padrão ou selecionados pelo utilizador, ou utilizar a ferramenta Design Space Explorer (DSE). O DSE, parte do Quartus II, executa automaticamente várias passagens de router utilizando uma semente diferente para cada passagem. A rota com a melhor frequência de relógio é guardada. Este é um processo automatizado que não requer intervenção do utilizador, mas demora significativamente mais tempo do que o método manual, que com o Quartus II demorava entre 1 e 6,5 horas, dependendo da dimensão do projeto.
O elevado nível de abstração aplicado pelo fluxo de projeto do DSP Builder Advanced Blockset acelera os ciclos de exploração e simulação do espaço algorítmico, reduzindo assim o tempo total necessário para obter um projeto final otimizado. No entanto, esta vantagem não é inerente ao Simulink da mesma forma que, por exemplo, a propagação de tipos de dados. Para tirar partido dos benefícios da exploração do espaço de projeto oferecidos pelo método de projeto baseado em blocos em comparação com o RTL escrito manualmente, o projetista deve tomar medidas adicionais ao criar o modelo do Simulink. Especificamente, o modelo deve ser estruturado de forma a permitir a exploração do espaço algorítmico com base em parâmetros. Para os exemplos analisados neste artigo, os modelos foram implementados para permitir testes com diferentes tamanhos de matrizes, tamanhos de vetores e (no caso do solver de Cholesky) o número de canais paralelos. Uma vez criado um modelo que incorpore esta flexibilidade, as estimativas de desempenho e utilização de recursos podem ser exploradas para várias configurações de projeto, variando estes parâmetros. É também necessário compreender o design de hardware para alcançar bons níveis de desempenho e utilização de recursos, como exemplificado pelo acumulador de ponto flutuante discutido na Secção 2 deste artigo.
A formação para o fluxo de trabalho de projeto do DSP Builder Advanced Blockset inclui 4 horas de aulas dadas pela Altera e aproximadamente 10 horas de seminários e demonstrações online. Além disso, a BDTI dedicou cerca de 90 horas ao estudo da ferramenta e de ambos os modelos em sessões práticas. O tempo e o esforço necessários para se tornar proficiente com o conjunto de ferramentas dependerão da capacidade e do conhecimento prévio do projetista.
Um engenheiro com experiência em design baseado em blocos do Simulink e em design de hardware irá provavelmente considerar o método baseado no DSP Builder Advanced Blockset eficiente e fácil de utilizar. Para um projetista de FPGA com pouco ou nenhum conhecimento de MATLAB e Simulink, projetar a um nível de abstração mais elevado pode representar uma nova forma de pensar e, portanto, um desafio inicial, que pode afetar a curva de aprendizagem. Uma vez familiarizado com a metodologia, o projetista pode alcançar ciclos de projeto significativamente mais rápidos do que com o HDL. Pode concentrar-se na implementação do algoritmo sem se preocupar com detalhes de design de hardware, como a segmentação. O tempo de projeto e verificação é significativamente reduzido, uma vez que a maior parte da simulação e da verificação funcional é realizada no ambiente Simulink. O resultado RTL da compilação no Simulink pode então ser executado no software ModelSim para uma simulação funcional completa.
A curva de aprendizagem pode ser menos acentuada para um engenheiro com conhecimentos prévios em design de sistemas e pouca ou nenhuma experiência em design de hardware. Embora o kit de ferramentas integre a compilação de hardware, a síntese, o encaminhamento e a geração automática de scripts no ambiente Simulink e abstraia diversos conceitos complexos de design, como a segmentação de dados e a vetorização de sinais, ainda é necessário algum conhecimento de hardware para completar uma implementação.
(Continua em abril)
Autor:
Pela equipa da Berkeley Design Technology, Inc. Outubro de 2012








