




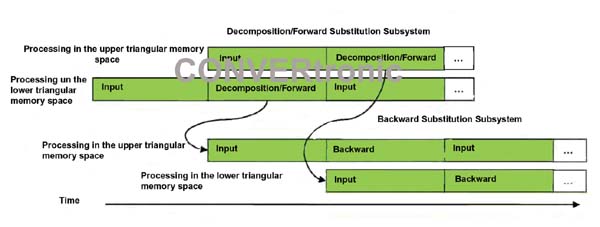
 Como a matriz de entrada é hermitiana e a decomposição gera matrizes triangulares complexas transpostas conjugadas, o uso da memória é otimizado carregando-se apenas a metade triangular inferior da matriz de entrada A e sobrescrevendo-a ao gerar a matriz triangular inferior L. Ambos os subsistemas são encadeados e utilizam um estágio de entrada e um estágio de processamento para permitir que o processamento ocorra numa área da memória enquanto a outra metade é usada para carregar novos dados. A saída dos estágios de decomposição e substituição direta é direcionada para o estágio de entrada da substituição inversa, como mostra a Figura 2.
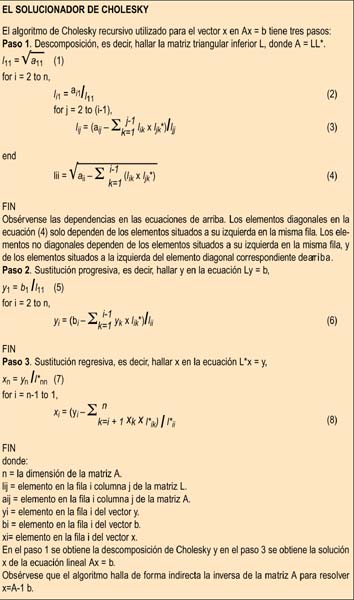
A parte principal da decomposição consiste no gerador de produto escalar complexo (também chamado de multiplicador vetorial), que calcula as equações (3) e (4). Para o dispositivo Stratix V é utilizado um tamanho de vetor (VS) até 90 elementos de dados complexos, enquanto que para o dispositivo Arria V é implementado um tamanho de vetor até 45 elementos de dados complexos. O tamanho do vetor corresponde ao número de leituras paralelas de memória necessárias para fornecer ao gerador de produto escalar um novo conjunto de dados a cada ciclo de relógio e, portanto, determina a largura e o particionamento da memória dual-port on-chip. Por razões de implementação, o armazenamento de um array de um determinado tamanho é dividido em (N/VS) bancos de memória teto, em que teto (VS) é a função teto e N é o tamanho do array.
O projeto do solver de Cholesky é multicanal. O número máximo de canais é um parâmetro de tempo de compilação e é apenas limitado pela memória disponível no dispositivo. O particionamento da memória é idêntico à implementação de canal único, com a diferença de que é criado um certo número de cópias da mesma estrutura.
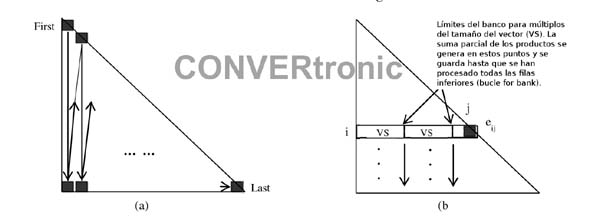
A decomposição é realizada elemento a elemento, coluna a coluna, começando no canto superior esquerdo e prosseguindo verticalmente num padrão em ziguezague, terminando no canto inferior direito da matriz, como mostra a Figura 3(a). Primeiro, é calculado o elemento diagonal de cada coluna, seguido por todos os elementos não diagonais abaixo dele na mesma coluna, antes de passar para o elemento diagonal no topo da coluna seguinte à direita. O cronograma de eventos e iterações é controlado por um ciclo for aninhado de quatro níveis. O laço mais externo processa a coluna; o segundo ciclo processa o banco; o terceiro ciclo interno processa as linhas; e o ciclo mais interno processa os diferentes canais. Colocar o processamento do canal como o ciclo mais interno transforma eficazmente o acumulador de ponto flutuante num acumulador de tempo partilhado e oculta melhor a sua latência. O bloco NestedLoops no DSP Builder Advanced Blockset integra até três ciclos aninhados num único bloco de processamento, acelerando a implementação e fazendo uma utilização mais eficiente dos recursos em comparação com uma função semelhante implementada como três blocos de ciclos for separados. O bloco extrai sinais de controlo de loop complexos, reduz o tempo de design e depuração e torna a estrutura do loop mais legível
 O gerador de produto escalar trabalha com as linhas da matriz e calcula multiplicações até ao tamanho do vetor no termo de soma das equações (3), (4) e (6) simultaneamente num único ciclo. É utilizada uma estrutura de memória circular na entrada do gerador de produto escalar nos ciclos de linha das múltiplas matrizes de entrada.
Para produtos escalares inferiores ao tamanho do vetor, os termos não utilizados são mascarados e não incluídos na soma. Para produtos escalares maiores que o tamanho do vetor, são calculadas somas parciais dos produtos e armazenadas dentro dos limites do banco até que todos os bancos disponíveis para um determinado elemento na linha correspondente sejam somados para obter a soma final, como mostrado na Figura 3(b). A soma das saídas dos bancos é realizada num único ciclo acumulador utilizando o bloco somador de ponto flutuante do DSP Builder Advanced Blockset. O ciclo de feedback tem uma latência de 13 ciclos. Ao trocar os laços de Bancos e Linhas em relação à sua ordem de implementação de software tradicional e ao adicionar processamento multicanal, a latência do acumulador de ponto flutuante é ocultada, melhorando a utilização do hardware.
O DSP Builder Advanced Blockset calcula automaticamente os atrasos do ciclo para lidar com esta latência. A ferramenta pode ser configurada para calcular e utilizar o atraso mínimo, marcando a caixa Atraso mínimo no bloco Atraso do ciclo. Os caminhos que causam atrasos idênticos podem receber um número de grupo de equivalência, e a ferramenta atribuirá o mesmo valor de atraso a todos os membros do grupo. Embora não seja utilizado nos exemplos avaliados neste artigo, o DSP Builder Advanced Blockset fornece um acumulador de ponto flutuante específico para a aplicação, que o utilizador pode personalizar para otimizar a sua velocidade e requisitos de recursos, configurando parâmetros como o tamanho máximo de entrada e a precisão de acumulação necessária. Este bloco permite a acumulação de um único fluxo de números de ponto flutuante num único ciclo por amostra, com uma frequência de relógio elevada.
 O segundo subsistema realiza a substituição inversa. Este subsistema possui os seus próprios blocos de memória de entrada e saída. Tal como o subsistema de substituição direta de Cholesky, está segmentado num estágio de entrada e num estágio de processamento. Como a complexidade da substituição inversa é da ordem de N² em comparação com N³ para a decomposição, o processamento vetorial não é utilizado para o produto interno. Em vez disso, é utilizado um único multiplicador complexo para o produto interno, o que é suficiente para seguir os passos da decomposição de Cholesky e do
 subsistema de decomposição direta.
Autor:
Pela equipa da Berkeley Design Technology, Inc. Outubro de 2012
(Continua em março)








