




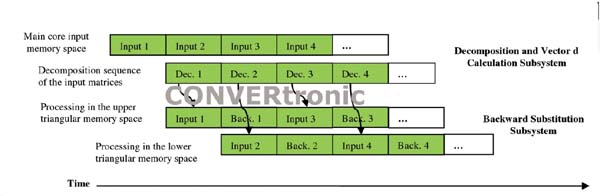
 Contrairement à Cholesky, où les équations (1) à (6) sont implémentées sous la forme d'une seule boucle imbriquée à quatre niveaux, le solveur QR utilise une seule machine à états finis (MEF) pour effectuer les quatre opérations principales : le calcul du carré de la norme d'un vecteur dans l'équation (2), le produit scalaire de deux vecteurs dans l'équation (4), la soustraction du produit scalaire d'un vecteur dans l'équation (6) et le produit scalaire dans l'équation (7) pour trouver le vecteur d. Le bloc NestedLoop du DSP Builder Advanced Blockset est utilisé dans toutes les phases de la MEF pour générer tous les signaux de contrôle d'événements pour le chemin de données.
Le bloc de traitement commun aux quatre opérations mentionnées ci-dessus est le générateur de produit scalaire. Afin d'améliorer les performances, le calcul du produit scalaire est effectué par traitement vectoriel. À l'instar de la conception de Cholesky, la taille du vecteur est un paramètre de compilation. Pour réutiliser ce générateur dans les quatre états de l'automate fini, un multiplexeur de données est utilisé en entrée et est contrôlé par le gestionnaire d'événements de l'automate. Le multiplexeur sélectionne les entrées appropriées pour le générateur de produit scalaire dans chaque état de l'automate. Les détails du générateur de produit scalaire et de l'accumulateur à virgule flottante sont similaires à ceux de la conception de Cholesky et ne sont donc pas détaillés ici.
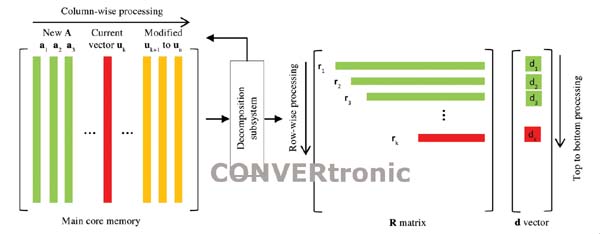
La mémoire requise pour la décomposition QR est optimisée par la réutilisation du bloc mémoire principal du noyau, qui contient initialement la matrice A et le vecteur d'entrée b. Le traitement s'effectue colonne par colonne, de gauche à droite, dans la mémoire du noyau. Une fois une colonne traitée et devenue inutile, elle est écrasée par la colonne correspondante d'une nouvelle matrice. Lorsque l'ancien tableau A se décompose, le contenu original de ce bloc de mémoire est remplacé par un nouveau tableau, maintenant ainsi la capacité de traitement de bout en bout du tableau sans interruption.
Dans les deux premiers états de l'automate fini, les éléments de la matrice R sont générés ligne par ligne, en commençant par l'élément diagonal de chaque ligne. Dans l'état de soustraction, les colonnes de la matrice A en mémoire principale sont mises à jour récursivement et remplacées par les vecteurs partiellement calculés. Par exemple, pour la colonne k, toutes les colonnes k+1 an sont mises à jour en mémoire en soustrayant la version normalisée de chacune des colonnes k+1 à n. Ce processus calcule récursivement les vecteurs uk+1 à un et constitue une version plus efficace de l'équation (6) pour une implémentation matérielle. Lors du quatrième état de l'automate fini, chaque uk nouvellement calculé est multiplié par le vecteur d'entrée b pour générer un élément dk du vecteur colonne d. La matrice Q n'est pas générée explicitement, mais ses colonnes orthogonales uk sont générées et utilisées dans les phases suivantes de l'automate fini. Ces colonnes sont ensuite écrasées dans la colonne correspondante ak de la nouvelle matrice lors du cycle suivant de l'automate fini. La figure 5 illustre l’organisation de la mémoire et la séquence de traitement du sous-système de décomposition QR.
Les sorties du premier sous-système sont la matrice R et le vecteur colonne d. La matrice R est triangulaire supérieure et est générée colonne par colonne, de gauche à droite, comme indiqué par les équations (3) et (4). Une structure de mémoire triangulaire en ping-pong est utilisée. Pendant que la partie triangulaire supérieure est traitée par le sous-système de rétro-substitution, la partie triangulaire inférieure est remplie par le sous-système de décomposition, et inversement. Le vecteur colonne d est ajouté à la matrice R et est généré colonne par colonne, de haut en bas. La sortie de la rétro-substitution est le vecteur solution x du système d'équations linéaires Ax = b.
Le solveur QR peut être implémenté dans un format multicanal similaire au solveur de Cholesky afin d'améliorer l'utilisation des ressources, de réduire la latence et d'accroître les performances. Cette amélioration est principalement due à la réduction effective de la latence de l'accumulateur à virgule flottante.
3. Méthodologie d'évaluation
du flux de conception et de la boîte à outils.
Pour cette évaluation, Altera a fourni à BDTI des implémentations des solveurs Cholesky et QR créées à l'aide du DSP Builder Advanced Blockset. Altera a mis à disposition des ingénieurs de BDTI un PC équipé des outils Altera et de MathWorks. Ces ingénieurs ont ensuite examiné, simulé et synthétisé les conceptions Altera dans l'environnement Simulink. Les conceptions synthétisées ont ensuite été appliquées à deux dispositifs distincts : les FPGA Stratix V et Arria V. Au cours de ce processus, BDTI a évalué le flux de conception d'Altera et les performances des deux exemples de conception.
Les cartes utilisées pour cette évaluation ne pouvant générer les stimuli pour les exemples de conception, chaque conception contient un bloc de génération de stimuli implémenté à l'aide des blocs du DSP Builder Advanced Blockset et compilé avec la conception de l'application testée. Afin de minimiser l'impact du bloc de stimuli sur les performances de la conception testée et sur l'utilisation des ressources FPGA, la matrice A est générée à la volée par le bloc de stimuli à partir d'un ensemble de données aléatoires beaucoup plus petit. Ce petit ensemble de données est généré à l'aide de scripts MATLAB (fichiers .m), chargé dans la mémoire du bloc de stimulation et compilé avec le circuit. Ces scripts MATLAB utilisent le même algorithme que le bloc de stimulation du circuit de test pour générer des données de référence à virgule flottante double précision pour le vecteur solution x, afin de mesurer le niveau d'erreur des modèles et circuits Simulink utilisés dans les FPGA. Dans le circuit de Cholesky, cet algorithme garantit une définition hermitienne positive pour la matrice A, tandis que le circuit utilisant le solveur QR garantit la création d'une matrice A bien conditionnée. Quatre configurations de vecteur, de matrice et de taille de canal ont été implémentées pour le solveur de Cholesky : trois sur le FPGA Stratix V et deux sur le circuit Arria V, une configuration étant commune aux deux. Pour le solveur QR, quatre configurations ont été implémentées sur le FPGA Stratix V, et deux d'entre elles ont également été implémentées sur le circuit Arria V. Toutes les configurations ont été évaluées en termes d'utilisation des ressources FPGA, de fréquence d'horloge maximale, de performances et de correction fonctionnelle. Les contraintes de conception du FPGA, telles que la fréquence d'horloge, la sélection du dispositif et le niveau de vitesse, sont spécifiées dans l'environnement Simulink.
 Les performances et les capacités ont été évaluées au niveau du modèle Simulink et de la plateforme matérielle. Le modèle Simulink des deux conceptions a été instrumenté pour visualiser le processus direct et le nombre total de cycles de traitement direct et inverse, tandis que le logiciel Quartus II a fourni la fréquence maximale (Fmax) atteinte pour chaque configuration. Chaque configuration a ensuite été téléchargée sur la plateforme matérielle, sa fréquence de fonctionnement a été fixée à Fmax, et le processus a été lancé. Les vecteurs de solution (x) de chaque solveur pour chaque configuration ont été enregistrés et comparés aux références correspondantes en virgule flottante double précision générées dans MATLAB.
Le script de post-simulation calcule la différence entre la sortie en virgule flottante simple précision IEEE 754 de Simulink et les vecteurs de référence en virgule flottante double précision générés dans MATLAB. De même, il calcule la différence entre la sortie issue des simulations matérielles et les références en virgule flottante double précision générées dans MATLAB.
L'évaluation de la boîte à outils Simulink
repose sur l'environnement MATLAB et requiert donc son utilisation. Dans cet environnement, les conceptions évaluées utilisent des blocs du DSP Builder Advanced Blockset, un ensemble de blocs distinct de la bibliothèque standard DSP Builder. Le DSP Builder Advanced Blockset est conçu pour une implémentation par blocs des algorithmes DSP et des chemins de données, et utilise un niveau d'abstraction plus élevé que la bibliothèque standard DSP Builder, qui comprend des blocs plus généraux et élémentaires. La bibliothèque DSP Builder Advanced Blockset contient plus de 50 fonctions trigonométriques, arithmétiques et booléennes courantes, ainsi que des blocs fonctionnels plus complexes pour la transformée de Fourier rapide (FFT) et les filtres FIR. Parmi les nouveautés notables de Quartus II version 12.0 figurent le calcul de la racine carrée à faible latence, les boucles imbriquées et les blocs d'accumulateurs à virgule flottante personnalisables. Les éléments du Standard Blockset et du DSP Builder Advanced Blockset ne peuvent pas être combinés au même niveau hiérarchique dans une structure de chemin de données. Seuls les blocs du DSP Builder Advanced Blockset prennent en charge le compilateur à virgule flottante. Les blocs du Standard Blockset ne sont pas optimisés pour le traitement à virgule flottante. De plus, bien que l'importation de code HDL manuel soit possible pour le Standard Blockset, elle ne l'est pas pour le DSP Builder Advanced Blockset, car cet outil ne peut pas effectuer d'implémentations au niveau HDL. En général, l'approche par blocs pour la saisie de la conception est bien adaptée aux algorithmes DSP ; cependant, comme des constructions telles que `case` ou `switch` ne sont pas disponibles dans la bibliothèque de blocs, une approche textuelle est plus intuitive pour les conceptions complexes à contrôle et celles impliquant des machines à états.
L'exécution d'une simulation avec DSP Builder Advanced Blockset compile le modèle Simulink, génère le code HDL et les contraintes pour l'environnement logiciel Quartus II d'Altera, crée un banc d'essai et des fichiers de script pour l'environnement ModelSim, puis simule le modèle Simulink. Les temps de simulation, pour différentes configurations, variaient de 3 à 28 minutes selon la taille du réseau, sur un PC équipé d'un processeur Intel Xeon W3550. La simulation Simulink fournit des estimations détaillées de l'utilisation des ressources sans nécessiter la compilation du logiciel Quartus II, permettant ainsi au concepteur de déterminer rapidement la taille de composant nécessaire. Lors de l'utilisation d'un kit de développement matériel (HDK), l'utilisateur doit définir l'affectation des broches de sortie en fonction du schéma de la carte. Il peut appliquer des contraintes sur les broches de sortie dans le fichier .qsf fourni, situé dans le dossier du projet Quartus II, ou utiliser la configuration des broches de Quartus II pour affecter et gérer les broches de sortie dès le départ.
Des tests ont été effectués sur le modèle afin d'évaluer la facilité d'exploration de l'algorithme et la génération du code HDL correspondant. Les paramètres d'entrée, tels que la taille du produit scalaire, la taille de la matrice et le type de données, ont été modifiés dans le bloc de stimulation et pendant l'exécution de la simulation. Dans tous les cas, le code RTL correct a été généré en quelques minutes et les résultats de la simulation concordent avec la référence MATLAB.
Toutes les configurations ont été synthétisées à l'aide du logiciel de conception Quartus II, accessible directement depuis l'environnement Simulink. Quartus II peut être utilisé en mode manuel avec les paramètres d'optimisation par défaut ou personnalisés, ou encore avec l'outil Design Space Explorer (DSE). Intégré à Quartus II, DSE exécute automatiquement plusieurs passes de routage en utilisant une valeur initiale différente pour chaque passe. La route présentant la meilleure fréquence d'horloge est enregistrée. Ce processus automatisé ne requiert aucune intervention de l'utilisateur, mais il est nettement plus long que la méthode manuelle, qui, avec Quartus II, prenait entre 1 et 6,5 heures selon la taille du circuit.
Le haut niveau d'abstraction appliqué par le flux de conception DSP Builder Advanced Blockset accélère les cycles d'exploration et de simulation de l'espace algorithmique, réduisant ainsi le temps global nécessaire à l'obtention d'une conception finale optimisée. Cependant, cet avantage n'est pas inhérent à Simulink, contrairement à la propagation des types de données, par exemple. Pour tirer parti des avantages de l'exploration de l'espace de conception offerts par la méthode de conception par blocs par rapport à la programmation RTL manuelle, le concepteur doit effectuer des étapes supplémentaires lors de la création du modèle Simulink. Plus précisément, le modèle doit être structuré de manière à permettre l'exploration de l'espace algorithmique en fonction des paramètres. Dans les exemples analysés dans cet article, les modèles ont été implémentés pour permettre des tests avec différentes tailles de matrices, de vecteurs et (dans le cas du solveur de Cholesky) le nombre de canaux parallèles. Une fois un modèle intégrant cette flexibilité créé, il est possible d'explorer les estimations de performance et d'utilisation des ressources pour diverses configurations de conception en faisant varier ces paramètres. Il est également nécessaire de comprendre la conception matérielle pour obtenir de bons niveaux de performance et d'utilisation des ressources, comme l'illustre l'accumulateur à virgule flottante présenté dans la section 2 de cet article.
La formation au flux de conception DSP Builder Advanced Blockset comprend 4 heures de cours dispensés par Altera et environ 10 heures de séminaires et démonstrations en ligne. Par ailleurs, BDTI a consacré environ 90 heures à l'étude pratique de l'outil et des deux modèles. Le temps et les efforts nécessaires pour maîtriser la boîte à outils dépendent des compétences et des connaissances préalables du concepteur.
Un ingénieur expérimenté en conception par blocs Simulink et en conception matérielle trouvera probablement la méthode basée sur DSP Builder Advanced Blockset efficace et facile à utiliser. Pour un concepteur FPGA ayant peu ou pas de connaissances de MATLAB et Simulink, concevoir à un niveau d'abstraction plus élevé peut représenter une nouvelle approche et donc un défi initial, ce qui peut influencer la courbe d'apprentissage. Une fois familiarisé avec la méthodologie, le concepteur peut réaliser des cycles de conception nettement plus rapides qu'avec HDL. Il peut se concentrer sur l'implémentation de l'algorithme sans se soucier des détails de conception matérielle tels que la segmentation. Le temps de conception et de vérification est considérablement réduit, car la majeure partie de la simulation et de la vérification fonctionnelle est effectuée dans l'environnement Simulink. Le code RTL généré par la compilation Simulink peut ensuite être exécuté dans le logiciel ModelSim pour une simulation fonctionnelle complète.
La courbe d'apprentissage sera probablement moins abrupte pour un ingénieur possédant déjà des connaissances en conception système et peu ou pas d'expérience en conception matérielle. Bien que la boîte à outils intègre la compilation matérielle, la synthèse, le routage et la génération automatique de scripts au sein de l'environnement Simulink, et qu'elle simplifie de nombreux concepts de conception complexes tels que la segmentation des données et la vectorisation des signaux, certaines connaissances en matériel restent nécessaires pour mener à bien une implémentation.
(À suivre en avril)
Auteur:
Par l'équipe de Berkeley Design Technology, Inc. Octobre 2012








