





Na tentativa de resolver este problema, os investigadores do MIT desenvolveram um modelo que compreende as relações subjacentes entre os objetos de uma cena. O seu modelo representa as relações individuais uma a uma e depois combina essas representações para descrever a cena como um todo. Isto permite que o modelo gere imagens mais precisas a partir de descrições textuais, mesmo quando a cena inclui múltiplos objetos dispostos em diferentes relações entre si.
Este trabalho pode ser aplicado em situações em que os robôs industriais necessitam de executar tarefas de manipulação complexas e com múltiplas etapas, como por exemplo, empilhar objetos num armazém ou montar eletrodomésticos. Além disso, aproxima-nos da possibilidade de as máquinas aprenderem com o meio ambiente e interagirem com ele da mesma forma que os humanos.
"Quando olho para uma mesa, não consigo dizer que existe um objeto na localização XYZ. As nossas mentes não funcionam desta forma. Na nossa mente, quando compreendemos uma cena, na verdade compreendemo-la em termos das relações entre os objetos. Acreditamos que, ao construir um sistema capaz de compreender estas relações, poderíamos utilizá-lo para manipular e modificar os nossos ambientes de forma mais eficaz", afirma Yilun Du, estudante de doutoramento no Laboratório de Ciência da Computação e Inteligência Artificial (CSAIL) e coautor do artigo.
Du é coautor do artigo com os autores seniores Shuang Li, estudante de doutoramento no CSAIL, e Nan Liu, estudante de pós-graduação na Universidade de Illinois em Urbana-Champaign; Joshua B. Tenenbaum, professor catedrático da Cátedra Paul E. Newton de Ciência Cognitiva e Computação no Departamento de Ciências do Cérebro e Cognitivas e membro do CSAIL; e o autor sénior Antonio Torralba, professor catedrático da Cátedra Delta de Engenharia Elétrica e Ciência da Computação e membro do CSAIL. A investigação será apresentada na Conferência sobre Sistemas de Processamento de Informação Neural, em dezembro.
 Um relacionamento de cada vez
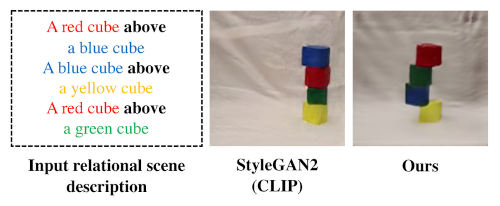
A estrutura desenvolvida pelos investigadores consegue gerar uma imagem de uma cena a partir de uma descrição textual dos objetos e das suas relações, como por exemplo: "Uma mesa de madeira à esquerda de um banco azul. Um sofá vermelho à direita de um banco azul.".
O seu sistema decompõe estas frases em duas partes mais pequenas que descrevem cada relação individual ("uma mesa de madeira à esquerda de um banco azul" e "um sofá vermelho à direita de um banco azul") e, em seguida, modela cada parte separadamente. Estas partes são depois combinadas através de um processo de otimização que gera uma imagem da cena.
Os investigadores utilizaram uma técnica de aprendizagem automática chamada modelação baseada em energia para representar as relações individuais dos objetos numa descrição de cena. Esta técnica permite-lhes utilizar um modelo baseado em energia para codificar cada descrição relacional e depois combiná-las para inferir todos os objetos e as suas relações.
Ao dividir as frases em partes mais pequenas para cada tipo de relação, o sistema consegue recombiná-las de várias formas, tornando-se mais capaz de se adaptar a descrições de cenas que nunca viu antes, explica Li.
"Outros sistemas considerariam todos os relacionamentos globalmente e gerariam a imagem de uma só vez a partir da descrição. No entanto, estas abordagens falham quando temos descrições fora da distribuição, como aquelas com mais relacionamentos, porque estes modelos não conseguem adaptar-se de uma só vez para gerar imagens que contenham mais relacionamentos. Contudo, ao combinar estes modelos separados e mais pequenos, podemos modelar um maior número de relacionamentos e adaptarmo-nos a novas combinações", diz Du.
O sistema também funciona de forma inversa: perante uma imagem, consegue encontrar descrições textuais que correspondam às relações entre os objetos da cena. Além disso, o seu modelo pode ser utilizado para editar uma imagem, reorganizando os objetos na cena para que correspondam a uma nova descrição.
Compreender cenas complexas
Os investigadores compararam o seu modelo a outros métodos de aprendizagem profunda que receberam descrições textuais e foram incumbidos de gerar imagens mostrando os objetos correspondentes e as suas relações. Em todos os casos, o seu modelo superou os métodos de referência.
Pediram ainda aos participantes que avaliassem se as imagens geradas correspondiam à descrição da cena original. Nos exemplos mais complexos, em que as descrições continham três relações, 91% dos participantes concluíram que o novo modelo teve um melhor desempenho.
"Uma descoberta interessante é que, para o nosso modelo, podemos passar de uma descrição de relação para duas, três ou até quatro descrições, e a nossa abordagem ainda consegue gerar imagens que são corretamente descritas por essas descrições, enquanto outros métodos falham", diz Du.
Os investigadores mostraram também ao modelo imagens de cenas que nunca tinha visto antes, bem como várias descrições textuais diferentes para cada imagem, e conseguiu identificar com sucesso a descrição que melhor se adequava às relações entre os objetos na imagem.
E quando os investigadores forneceram ao sistema duas descrições de cenas relacionais que descreviam a mesma imagem, mas de formas diferentes, o modelo conseguiu compreender que as descrições eram equivalentes.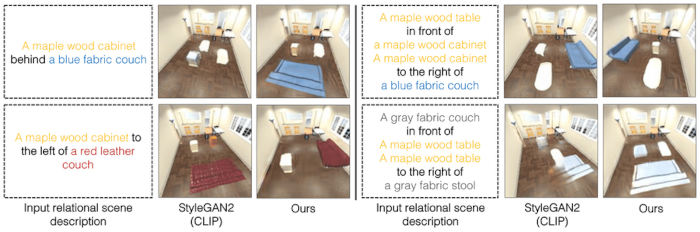
Os investigadores ficaram impressionados com a robustez do modelo, especialmente quando trabalhavam com descrições que não tinham encontrado antes.
"Isto é muito promissor porque se assemelha mais à forma como os humanos funcionam. Os humanos veem apenas alguns exemplos, mas nós podemos extrair informações úteis desses poucos exemplos e combiná-los para criar infinitas combinações. E o nosso modelo tem essa propriedade que lhe permite aprender com menos dados, mas generalizar para cenas mais complexas ou gerações de imagens", diz Li.
Embora estes resultados iniciais sejam encorajadores, os investigadores gostariam de ver como o seu modelo se comporta em imagens mais complexas do mundo real, com fundos ruidosos e objetos a bloquearem-se uns aos outros.
Têm também interesse em incorporar o seu modelo em sistemas robóticos, para que um robô possa inferir as relações entre objetos a partir de vídeos e aplicar esse conhecimento para os manipular no mundo real.
"Desenvolver representações visuais capazes de lidar com a natureza composicional do mundo que nos rodeia é um dos principais problemas em aberto na visão computacional. Este trabalho representa um avanço significativo neste problema, ao propor um modelo baseado na energia que modela explicitamente as múltiplas relações entre os objetos representados na imagem. Os resultados são realmente impressionantes", afirma Josef Sivic, investigador sénior do Instituto Checo de Informática, Robótica e Cibernética da Universidade Técnica Checa, que não participou nesta investigação.
Esta investigação recebeu apoio, em parte, da Raytheon BBN Technologies Corp., do Laboratório de Investigação da Mitsubishi Electric, da Fundação Nacional de Ciência (National Science Foundation), do Gabinete de Investigação Naval (Office of Naval Research) e do Centro de Investigação Thomas J. Watson da IBM.
###
Escrito por Adam Zewe, MIT News Office













