





Pour tenter de résoudre ce problème, des chercheurs du MIT ont développé un modèle capable de comprendre les relations sous-jacentes entre les objets d'une scène. Ce modèle représente chaque relation individuellement, puis combine ces représentations pour décrire la scène dans son ensemble. Grâce à cela, il peut générer des images plus précises à partir de descriptions textuelles, même lorsque la scène comprend plusieurs objets agencés de manière diverse.
Ces travaux pourraient trouver des applications dans des situations où des robots industriels doivent effectuer des tâches de manipulation complexes et en plusieurs étapes, comme l'empilage d'objets dans un entrepôt ou l'assemblage d'appareils électroménagers. De plus, ils nous rapprochent de la possibilité pour les machines d'apprendre de leur environnement et d'interagir avec lui de la même manière que les humains.
« Quand je regarde une table, je ne peux pas dire qu'il y a un objet à l'emplacement XYZ. Notre esprit ne fonctionne pas ainsi. Lorsque nous comprenons une scène, nous la comprenons en réalité à travers les relations entre les objets. Nous pensons qu'en concevant un système capable de comprendre ces relations, nous pourrions l'utiliser pour manipuler et modifier notre environnement plus efficacement », explique Yilun Du, doctorant au Laboratoire d'informatique et d'intelligence artificielle (CSAIL) et co-auteur de l'article.
Du a co-écrit l'article avec Shuang Li, doctorante au CSAIL, et Nan Liu, étudiante diplômée à l'Université de l'Illinois à Urbana-Champaign ; Joshua B. Tenenbaum, professeur titulaire de la chaire Paul E. Newton de développement de carrière en sciences cognitives et informatique au sein du département des sciences du cerveau et des sciences cognitives et membre du CSAIL ; et Antonio Torralba, professeur titulaire de la chaire Delta de génie électrique et d'informatique et membre du CSAIL. Ces travaux de recherche seront présentés lors de la Conférence sur les systèmes de traitement de l'information neuronale en décembre.
 Une relation à la fois
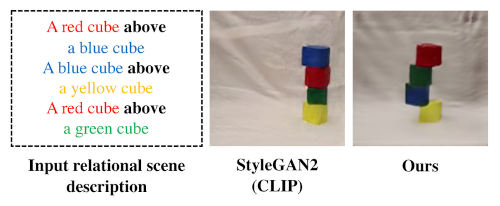
Le cadre développé par les chercheurs peut générer une image d'une scène à partir d'une description textuelle des objets et de leurs relations, comme par exemple : « Une table en bois à gauche d'un tabouret bleu. Un canapé rouge à droite d'un tabouret bleu. ».
Leur système décompose ces phrases en deux parties plus petites décrivant chacune une relation individuelle (« une table en bois à gauche d'un tabouret bleu » et « un canapé rouge à droite d'un tabouret bleu »), puis modélise chaque partie séparément. Ces éléments sont ensuite combinés par un processus d'optimisation qui génère une image de la scène.
Les chercheurs ont utilisé une technique d'apprentissage automatique appelée modélisation énergétique pour représenter les relations individuelles entre les objets d'une scène. Cette technique leur permet d'utiliser un modèle énergétique pour encoder chaque description relationnelle, puis de les combiner afin de déduire l'ensemble des objets et de leurs relations.
En décomposant les phrases en segments plus courts pour chaque relation, le système peut les recombiner de diverses manières, ce qui le rend plus apte à s'adapter à des descriptions de scènes qu'il n'a jamais vues auparavant, explique Li.
« D’autres systèmes prendraient en compte toutes les relations à l’échelle globale et généreraient l’image d’un seul coup à partir de la description. Cependant, ces approches échouent face à des descriptions hors distribution, comme celles comportant davantage de relations, car ces modèles ne peuvent pas s’adapter simultanément pour générer des images contenant plus de relations. En revanche, en combinant ces modèles distincts et plus petits, nous pouvons modéliser un plus grand nombre de relations et nous adapter à de nouvelles combinaisons », explique Du.
Le système fonctionne également en sens inverse : à partir d’une image, il peut trouver des descriptions textuelles correspondant aux relations entre les objets de la scène. De plus, son modèle permet de modifier une image en réorganisant les objets de la scène pour qu’ils correspondent à une nouvelle description.
Comprendre des scènes complexes
Les chercheurs ont comparé leur modèle à d'autres méthodes d'apprentissage profond qui, à partir de descriptions textuelles, devaient générer des images illustrant les objets correspondants et leurs relations. Dans tous les cas, leur modèle a surpassé les méthodes de référence.
Ils ont également demandé à des humains d'évaluer si les images générées correspondaient à la description de la scène originale. Dans les exemples les plus complexes, où les descriptions contenaient trois relations, 91 % des participants ont conclu que le nouveau modèle était plus performant.
« Ce que nous avons découvert d'intéressant, c'est que, pour notre modèle, nous pouvons passer d'une description de relation à deux, trois, voire quatre descriptions, et notre approche est toujours capable de générer des images correctement décrites par ces descriptions, alors que d'autres méthodes échouent », explique Du.
Les chercheurs ont également montré au modèle des images de scènes qu'il n'avait jamais vues auparavant, ainsi que plusieurs descriptions textuelles différentes de chaque image, et il a été capable d'identifier avec succès la description qui correspondait le mieux aux relations entre les objets dans l'image.
Et lorsque les chercheurs ont présenté au système deux descriptions de scènes relationnelles décrivant la même image mais de manières différentes, le modèle a été capable de comprendre que les descriptions étaient équivalentes.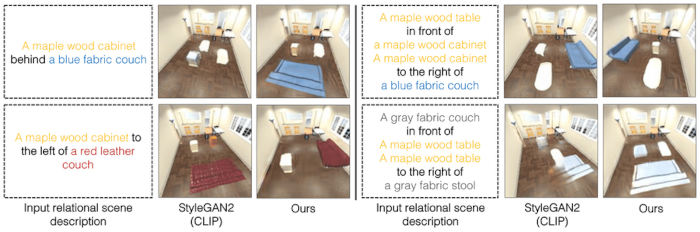
Les chercheurs ont été impressionnés par la robustesse de son modèle, notamment lorsqu'il travaillait avec des descriptions qu'il n'avait jamais rencontrées auparavant.
« C’est très prometteur car cela se rapproche davantage du fonctionnement humain. Les humains ne voient que quelques exemples, mais nous pouvons en extraire des informations utiles et les combiner pour créer une infinité de combinaisons. Notre modèle possède cette propriété qui lui permet d’apprendre à partir de moins de données tout en généralisant à des scènes plus complexes ou à des générations d’images », explique Li.
Bien que ces premiers résultats soient encourageants, les chercheurs aimeraient voir comment leur modèle se comporte sur des images réelles plus complexes, avec des arrière-plans bruités et des objets qui se masquent mutuellement.
Ils souhaitent également intégrer leur modèle dans des systèmes robotiques, afin qu'un robot puisse déduire les relations entre les objets à partir de vidéos et appliquer ces connaissances pour les manipuler dans le monde réel.
« L’élaboration de représentations visuelles capables de rendre compte de la complexité du monde qui nous entoure est l’un des principaux défis de la vision par ordinateur. Ce travail constitue une avancée significative en proposant un modèle énergétique qui modélise explicitement les multiples relations entre les objets représentés dans l’image. Les résultats sont véritablement impressionnants », déclare Josef Sivic, chercheur principal à l’Institut tchèque d’informatique, de robotique et de cybernétique de l’Université technique tchèque, qui n’a pas participé à ces recherches.
Ces travaux de recherche sont soutenus, en partie, par Raytheon BBN Technologies Corp., le laboratoire de recherche Mitsubishi Electric, la National Science Foundation, l'Office of Naval Research et le centre de recherche Thomas J. Watson d'IBM.
###
Article rédigé par Adam Zewe, service de presse du MIT













