




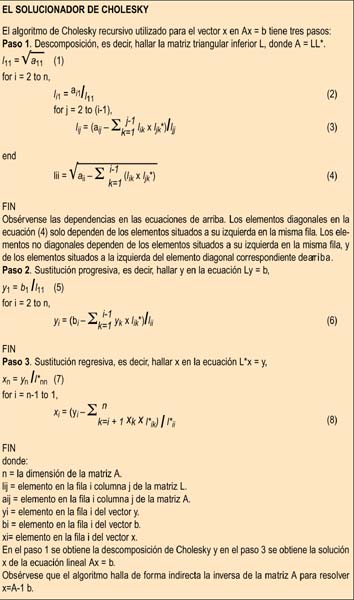
 Comme la matrice d'entrée est hermitienne et que la décomposition génère des matrices triangulaires complexes conjuguées transposées, l'utilisation de la mémoire est optimisée en ne chargeant que la moitié triangulaire inférieure de la matrice d'entrée A et en l'écrasant lors de la génération de la moitié triangulaire inférieure L. Les deux sous-systèmes sont pipelinés et utilisent une étape d'entrée et une étape de traitement afin que le traitement s'effectue dans une zone de mémoire tandis que l'autre moitié est utilisée pour charger de nouvelles données. La sortie des étapes de décomposition et de substitution directe est transmise à l'étape d'entrée de la substitution inverse, comme illustré sur la figure 2.
La partie principale de la décomposition consiste en le générateur de produit scalaire complexe (également appelé multiplicateur vectoriel), qui calcule les équations (3) et (4). Pour le dispositif Stratix V, une taille de vecteur (VS) allant jusqu'à 90 éléments de données complexes est utilisée, tandis que pour le dispositif Arria V, une taille de vecteur allant jusqu'à 45 éléments de données complexes est implémentée. La taille du vecteur correspond au nombre de lectures mémoire parallèles nécessaires pour fournir au générateur de produit scalaire un nouvel ensemble de données à chaque cycle d'horloge, et détermine ainsi la largeur et le partitionnement de la mémoire double port intégrée. Pour des raisons d'implémentation, le stockage d'un tableau d'une taille donnée est divisé en (N/VS) banques de mémoire plafond, où plafond(VS) est la fonction plafond et N la taille du tableau.
La conception du solveur de Cholesky est multicanal. Le nombre maximal de canaux est un paramètre de compilation et est limité uniquement par la mémoire disponible sur le dispositif. Le partitionnement de la mémoire est identique à l'implémentation monocanal, à la différence qu'un certain nombre de copies de la même structure sont effectuées.
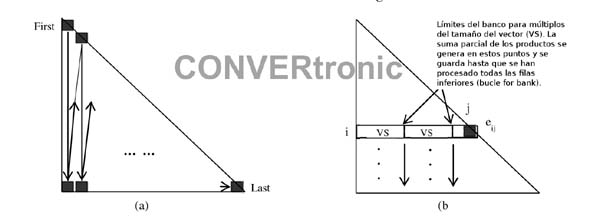
La décomposition est effectuée élément par élément, colonne par colonne, en commençant par le coin supérieur gauche et en progressant verticalement en zigzag, jusqu'au coin inférieur droit de la matrice, comme illustré sur la figure 3(a). On calcule d'abord l'élément diagonal de chaque colonne, puis tous les éléments non diagonaux situés en dessous dans la même colonne, avant de passer à l'élément diagonal en haut de la colonne suivante à droite. Le cycle d'événements et d'itérations est géré par une boucle « for » imbriquée à quatre niveaux. La boucle externe traite la colonne ; la deuxième boucle traite la banque ; la troisième boucle interne traite les lignes ; et la boucle interne traite les différents canaux. Le fait de placer le traitement des canaux dans la boucle interne transforme l'accumulateur à virgule flottante en un accumulateur à temps partagé et masque mieux sa latence. Le bloc NestedLoops du DSP Builder Advanced Blockset intègre jusqu'à trois boucles imbriquées dans un seul bloc de traitement, ce qui accélère l'implémentation et optimise l'utilisation des ressources par rapport à une fonction similaire implémentée avec trois blocs de boucle « for » distincts. Ce bloc extrait les signaux de contrôle de boucle complexes, réduit le temps de conception et de débogage et rend la structure de la boucle plus lisible
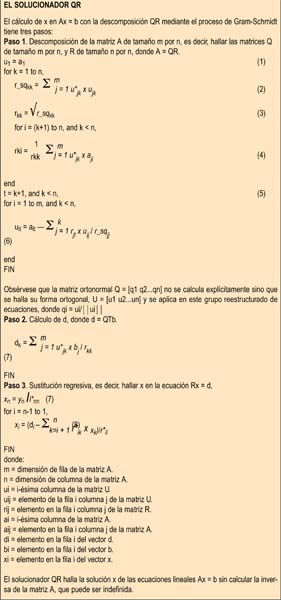 Le générateur de produit scalaire traite les lignes de la matrice et calcule simultanément, en un seul cycle, les multiplications jusqu'à la taille du vecteur dans le terme de somme des équations (3), (4) et (6). Une structure de mémoire circulaire est utilisée à l'entrée du générateur de produit scalaire, par cycles de lignes des matrices d'entrée multiples.
Pour les produits scalaires inférieurs à la taille du vecteur, les termes inutilisés sont masqués et exclus de la somme. Pour les produits scalaires supérieurs à la taille du vecteur, des sommes partielles sont calculées et stockées dans les limites des banques jusqu'à ce que toutes les banques disponibles pour un élément donné de la ligne correspondante soient additionnées pour obtenir la somme finale, comme illustré sur la figure 3(b). L'addition des sorties des banques est effectuée dans une boucle d'accumulateur unique à l'aide du bloc additionneur à virgule flottante du DSP Builder Advanced Blockset. La boucle de rétroaction présente une latence de 13 cycles. En inversant l'ordre des boucles « Banques » et « Lignes » par rapport à leur implémentation logicielle traditionnelle, et en ajoutant un traitement multicanal, la latence de l'accumulateur à virgule flottante est masquée, ce qui améliore l'utilisation du matériel.
Le DSP Builder Advanced Blockset calcule automatiquement les délais de boucle pour compenser cette latence. L'outil peut être configuré pour calculer et utiliser le délai minimal en cochant la case « Délai minimal » dans le bloc « Délai de boucle ». Les chemins induisant des délais identiques peuvent se voir attribuer un numéro de groupe d'équivalence, et l'outil attribuera alors la même valeur de délai à tous les membres du groupe. Bien que non utilisé dans les exemples analysés dans cet article, le bloc avancé DSP Builder fournit un accumulateur à virgule flottante dédié à l'application, que l'utilisateur peut personnaliser afin d'optimiser sa vitesse et ses besoins en ressources en configurant des paramètres tels que la taille maximale des données d'entrée et la précision d'accumulation requise. Ce bloc permet l'accumulation d'un flux unique de nombres à virgule flottante à une fréquence d'horloge élevée, avec un cycle par échantillon.
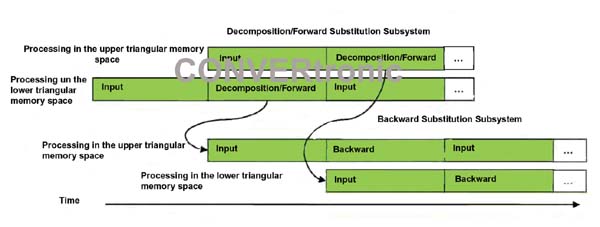 Le second sous-système effectue la substitution inverse. Ce sous-système possède ses propres blocs de mémoire d'entrée et de sortie. À l'instar du sous-système de substitution directe de Cholesky, il est segmenté en une étape d'entrée et une étape de traitement. La complexité de la substitution inverse étant de l'ordre de N², contre N³ pour la décomposition, le traitement vectoriel n'est pas utilisé pour le produit scalaire. Un simple multiplicateur complexe est employé à la place, ce qui suffit pour reproduire les étapes de la décomposition de Cholesky et du
 sous-système de décomposition directe.
Auteur:
Par l'équipe de Berkeley Design Technology, Inc. Octobre 2012
(À suivre en mars)








