




 A differenza di Cholesky, dove le equazioni (1) a (6) sono implementate come un singolo ciclo annidato a quattro livelli, il risolutore QR impiega una singola macchina a stati finiti (FSM) per eseguire ciclicamente le quattro operazioni principali: trovare il quadrato della magnitudine di un vettore nell'equazione (2), il prodotto scalare di due vettori nell'equazione (4), la sottrazione di un prodotto scalare di un vettore nell'equazione (6) e il prodotto scalare nell'equazione (7) per trovare il vettore d. Il blocco NestedLoop nel DSP Builder Advanced Blockset viene utilizzato in tutte le fasi della FSM per generare tutti i segnali di controllo degli eventi per il percorso dati.
Il blocco di elaborazione comune alle quattro operazioni sopra menzionate è il generatore di prodotto scalare. Per migliorare le prestazioni, viene utilizzata l'elaborazione vettoriale per calcolare il prodotto scalare. Analogamente al progetto di Cholesky, la dimensione del vettore è un parametro di compilazione. Per riutilizzare questo generatore nei quattro stati della macchina a stati finiti (FSM), viene utilizzato un multiplexer di dati in ingresso, controllato dal gestore eventi della FSM. Il multiplexer seleziona gli input corretti per il generatore di prodotto scalare in ciascuno stato della FSM. I dettagli del generatore di prodotto scalare e dell'accumulatore in virgola mobile sono simili a quelli del progetto di Cholesky e pertanto non sono inclusi in questa sede.
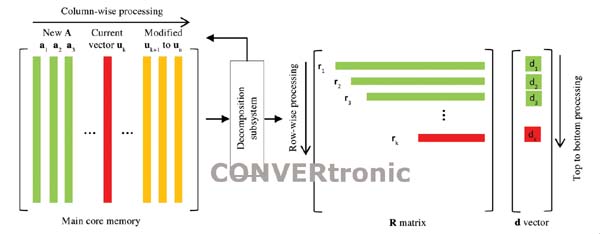
La memoria necessaria per la decomposizione QR è ottimizzata riutilizzando il blocco di memoria principale del kernel che inizialmente contiene la matrice A e il vettore di input b. L'elaborazione avviene per colonne, da sinistra a destra, nella memoria del kernel. Una volta completata una colonna e non più necessaria, viene sovrascritta con la colonna corrispondente di una nuova matrice. Quando il vecchio array A si decompone, il contenuto originale di questo blocco di memoria viene sostituito da un nuovo array, mantenendo così la capacità di elaborazione end-to-end dell'array senza interruzioni.
Nei primi due stati dell'FSM, gli elementi della matrice R vengono generati elemento per elemento in direzione riga, partendo dall'elemento diagonale per ogni riga. Nello stato di sottrazione dell'FSM, le colonne della matrice A nella memoria principale vengono aggiornate ricorsivamente e sostituite con i vettori parzialmente calcolati. Ad esempio, nella colonna k, tutte le colonne k+1 e an vengono aggiornate in memoria sottraendo la versione scalata di da ciascuna delle colonne da k+1 a n. Questo processo calcola ricorsivamente i vettori da uk+1 a un ed è una versione più efficiente dell'equazione (6) per l'implementazione hardware. Elaborando per colonne nel quarto stato dell'FSM, ogni uk appena calcolato viene moltiplicato per il vettore di input b per generare un singolo elemento dk del vettore colonna d. La matrice Q non viene generata esplicitamente, ma le sue colonne ortogonali, uk, vengono generate e utilizzate nelle fasi successive dell'FSM. Queste colonne vengono quindi sovrascritte nella colonna corrispondente, ak, della nuova matrice nel ciclo FSM successivo. La Figura 5 mostra l'organizzazione della memoria e la sequenza di elaborazione del sottosistema di decomposizione QR.
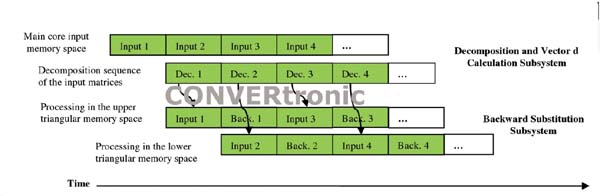
Gli output del primo sottosistema sono la matrice R e il vettore colonna d. La matrice R è una matrice triangolare superiore e viene generata colonna per colonna da sinistra a destra, come indicato dalle equazioni (3) e (4). Viene applicata una struttura di memoria triangolare ping-pong. Mentre la sezione triangolare superiore viene elaborata nel sottosistema di sostituzione all'indietro, la sezione triangolare inferiore viene riempita dal sottosistema di decomposizione, e viceversa. Il vettore colonna d viene aggiunto alla matrice R e viene generato colonna per colonna dall'alto verso il basso. L'output della sostituzione all'indietro è il vettore soluzione x delle equazioni lineari Ax = b.
Il risolutore QR può essere implementato in un formato multicanale simile al risolutore di Cholesky per migliorare l'utilizzo, ridurre la latenza e aumentare le prestazioni del progetto. Il miglioramento delle prestazioni è dovuto principalmente all'efficace riduzione della latenza dell'accumulatore in virgola mobile.
3. Metodologia di valutazione
del flusso di progettazione e del toolkit
Per questa valutazione, Altera ha fornito a BDTI implementazioni dei risolutori Cholesky e QR create utilizzando il DSP Builder Advanced Blockset. Altera ha fornito agli ingegneri di BDTI un PC con preinstallati gli strumenti Altera e MathWorks. Gli ingegneri di BDTI hanno quindi esaminato, simulato e sintetizzato i progetti Altera all'interno dell'ambiente Simulink. I progetti sintetizzati sono stati poi applicati a due dispositivi separati: le FPGA Stratix V e Arria V. Durante questo processo, BDTI ha valutato il flusso di progettazione di Altera e le prestazioni dei due progetti di esempio.
Poiché le schede utilizzate per questa valutazione non potevano generare gli stimoli per i progetti di esempio, ogni progetto contiene un blocco di generazione di stimoli implementato utilizzando i blocchi del DSP Builder Advanced Blockset e compilato con il progetto dell'applicazione in fase di test. Per ridurre al minimo l'impatto del blocco di stimoli sulle prestazioni del progetto di test e sull'utilizzo delle risorse FPGA, la matrice A viene generata al volo dal blocco di stimoli a partire da un set di dati casuali molto più piccolo. Questo piccolo dataset viene generato utilizzando script m-file in MATLAB, caricati nella memoria del blocco di stimolo e compilati con il progetto. Questi script MATLAB utilizzano lo stesso algoritmo del blocco di stimolo nel progetto di test per generare dati di riferimento in virgola mobile a doppia precisione per il vettore soluzione x, al fine di misurare il livello di errore dei modelli e dei progetti Simulink immessi nelle FPGA. Nel progetto Cholesky, questo algoritmo garantisce una definizione hermitiana positiva per la matrice A, mentre il progetto che utilizza il risolutore QR garantisce la creazione di una matrice A ben condizionata. Per il progetto con il risolutore Cholesky sono state implementate quattro configurazioni di vettori, matrici e dimensioni dei canali: tre sulla FPGA Stratix V e due sul dispositivo Arria V, con una configurazione comune a entrambi. Per il progetto con il risolutore QR, sono state implementate quattro configurazioni sulla FPGA Stratix V, e due di queste sono state implementate anche sul dispositivo Arria V. Tutte le configurazioni sono state valutate in termini di utilizzo delle risorse FPGA, frequenza di clock massima, prestazioni e correttezza funzionale. I vincoli di progettazione dell'FPGA, come la frequenza di clock, la selezione del dispositivo e il livello di velocità, vengono specificati nell'ambiente Simulink.
 Le prestazioni e le capacità sono state valutate sia a livello di modello Simulink che di piattaforma hardware. Il modello Simulink per entrambi i progetti è stato strumentato per visualizzare sia il processo diretto che il numero totale di cicli di elaborazione in avanti e all'indietro, mentre il software Quartus II ha fornito la frequenza massima (Fmax) raggiunta per ciascuna configurazione. Ciascuna configurazione è stata quindi scaricata sulla piattaforma hardware, la sua frequenza operativa è stata impostata su Fmax e il processo è stato avviato. I vettori soluzione (x) di ciascun risolutore per ogni configurazione sono stati acquisiti e confrontati con i corrispondenti riferimenti in virgola mobile a doppia precisione generati in MATLAB.
Lo script di post-simulazione calcola la differenza tra l'output a virgola mobile a singola precisione IEEE 754 di Simulink e i vettori di riferimento a virgola mobile a doppia precisione generati in MATLAB. Analogamente, lo script calcola la differenza tra l'output acquisito dalle simulazioni hardware e i riferimenti a virgola mobile a doppia precisione generati in MATLAB.
La valutazione del toolkit Simulink
si basa sull'ambiente MATLAB e, pertanto, lo richiede. Nell'ambiente Simulink, i progetti valutati utilizzano blocchi del DSP Builder Advanced Blockset, un set di blocchi separato dalla libreria standard di DSP Builder. Il DSP Builder Advanced Blockset è orientato a un'implementazione basata su blocchi di algoritmi DSP e percorsi dati e utilizza un livello di astrazione superiore rispetto alla libreria standard di DSP Builder, che include blocchi più generali ed elementari. La libreria DSP Builder Advanced Blockset contiene oltre 50 funzioni trigonometriche, aritmetiche e booleane comuni, oltre ai blocchi funzionali più complessi per la Trasformata di Fourier Veloce (FFT) e i filtri FIR. Tra le novità più importanti della versione 12.0 di Quartus II si annoverano i blocchi per la radice quadrata a bassa latenza, i cicli for annidati e gli accumulatori a virgola mobile personalizzabili. Gli elementi del Standard Blockset e del DSP Builder Advanced Blockset non possono essere combinati in una struttura di percorso dati allo stesso livello gerarchico; solo i blocchi del DSP Builder Advanced Blockset supportano il compilatore a virgola mobile. I blocchi dello Standard Blockset non sono ottimizzati per l'elaborazione in virgola mobile. Inoltre, mentre l'importazione di codice HDL scritto manualmente è disponibile per lo Standard Blockset, non lo è per il DSP Builder Advanced Blockset perché lo strumento non è in grado di eseguire implementazioni a livello HDL. In generale, l'approccio basato sui blocchi per l'input di progettazione è adatto agli algoritmi DSP; tuttavia, poiché costrutti come `case` o `switch` non sono disponibili nella libreria di blocchi, un approccio basato sul testo risulta più intuitivo per progetti ad alta intensità di controllo e per quelli che coinvolgono macchine a stati.
L'esecuzione di una simulazione con DSP Builder Advanced Blockset compila il modello Simulink, genera codice HDL e vincoli per l'ambiente software Quartus II di Altera, crea un test bench e file di script per l'ambiente ModelSim e simula il modello Simulink. I tempi di simulazione per varie configurazioni variavano da 3 a 28 minuti, a seconda delle dimensioni dell'array, utilizzando un PC Intel Xeon W3550. La simulazione Simulink fornisce stime dettagliate sull'utilizzo delle risorse senza richiedere la compilazione del software Quartus II, aiutando così il progettista a determinare rapidamente le dimensioni necessarie del dispositivo. Quando si utilizza un kit di sviluppo hardware, l'utente deve fornire l'assegnazione dei pin di output in base al layout della scheda. L'utente può applicare i vincoli sui pin di output nel file .qsf fornito nella cartella del progetto software Quartus II per il progetto, oppure utilizzare la configurazione dei pin del software Quartus II per assegnare e gestire i pin di output fin dall'inizio.
Sono stati effettuati dei test sul modello per valutare la facilità di esplorazione dell'algoritmo e la generazione del corrispondente codice HDL. I parametri di input, come la dimensione del prodotto scalare, la dimensione della matrice e il tipo di dati, sono stati modificati nel blocco di stimolo e durante l'esecuzione della simulazione. In tutti i casi, il codice RTL corretto è stato generato in pochi minuti e i risultati della simulazione corrispondevano al riferimento MATLAB.
Tutte le configurazioni sono state sintetizzate utilizzando il software di progettazione Quartus II, che può essere avviato direttamente dall'ambiente Simulink. Un progettista può utilizzare Quartus II in modalità "a pulsante" con parametri di ottimizzazione predefiniti o selezionati dall'utente, oppure utilizzare lo strumento Design Space Explorer (DSE). DSE, parte integrante di Quartus II, esegue automaticamente più passaggi di routing utilizzando un seed diverso per ogni passaggio. Il percorso con la frequenza di clock migliore viene salvato. Si tratta di un processo automatizzato che non richiede alcun intervento da parte dell'utente, ma che richiede molto più tempo rispetto al metodo "a pulsante", il quale con Quartus II richiedeva da 1 a 6,5 ore a seconda delle dimensioni del progetto.
L'elevato livello di astrazione applicato dal flusso di progettazione Advanced Blockset di DSP Builder accelera i cicli di esplorazione e simulazione dello spazio algoritmico, riducendo così il tempo complessivo necessario per ottenere un progetto finale ottimizzato. Tuttavia, questo vantaggio non è intrinseco a Simulink nello stesso modo in cui lo è, ad esempio, la propagazione dei tipi di dati. Per sfruttare i benefici dell'esplorazione dello spazio di progettazione offerti dal metodo di progettazione a blocchi rispetto alla scrittura manuale di codice RTL, il progettista deve adottare ulteriori accorgimenti durante la creazione del modello Simulink. In particolare, il modello deve essere strutturato in modo da consentire l'esplorazione dello spazio algoritmico in base ai parametri. Per gli esempi analizzati in questo articolo, i modelli sono stati implementati per consentire test con diverse dimensioni di matrici, dimensioni di vettori e (nel caso del risolutore di Cholesky) numero di canali paralleli. Una volta creato un modello che incorpora questa flessibilità, è possibile esplorare le stime di prestazioni e utilizzo delle risorse per varie configurazioni di progetto variando questi parametri. È inoltre necessario comprendere la progettazione hardware per ottenere buoni livelli di prestazioni e utilizzo delle risorse, come esemplificato dall'accumulatore in virgola mobile discusso nella Sezione 2 di questo articolo.
La formazione per il flusso di lavoro di progettazione DSP Builder Advanced Blockset comprende 4 ore di lezioni tenute da Altera e circa 10 ore di seminari e dimostrazioni online. Inoltre, BDTI ha dedicato circa 90 ore allo studio dello strumento e di entrambi i modelli in sessioni pratiche. Il tempo e l'impegno necessari per acquisire familiarità con il toolkit dipenderanno dalle competenze e dalle conoscenze pregresse del progettista.
Un ingegnere esperto nella progettazione basata su blocchi Simulink e nella progettazione hardware troverà probabilmente il metodo DSP Builder Advanced Blockset efficiente e facile da usare. Per un progettista FPGA con poca o nessuna conoscenza di MATLAB e Simulink, progettare a un livello di astrazione superiore può rappresentare un nuovo modo di pensare e quindi una sfida iniziale, che può influenzare la curva di apprendimento. Una volta acquisita familiarità con la metodologia, il progettista può ottenere cicli di progettazione significativamente più rapidi rispetto all'HDL. Può concentrarsi sull'implementazione dell'algoritmo senza preoccuparsi dei dettagli di progettazione hardware come la segmentazione. I tempi di progettazione e verifica sono notevolmente ridotti poiché la maggior parte della simulazione e della verifica funzionale viene eseguita nell'ambiente Simulink. L'output RTL della build Simulink può quindi essere eseguito nel software ModelSim per una simulazione funzionale completa.
La curva di apprendimento potrebbe essere meno ripida per un ingegnere con precedenti conoscenze di progettazione a livello di sistema e poca o nessuna esperienza nella progettazione hardware. Sebbene il toolkit integri la compilazione hardware, la sintesi, il routing e la generazione automatica di script all'interno dell'ambiente Simulink e astragga numerosi concetti di progettazione complessi come la segmentazione dei dati e la vettorizzazione del segnale, è comunque necessaria una certa conoscenza hardware per completare un'implementazione.
(Continua ad aprile)
Autore:
A cura del team di Berkeley Design Technology, Inc. Ottobre 2012








