




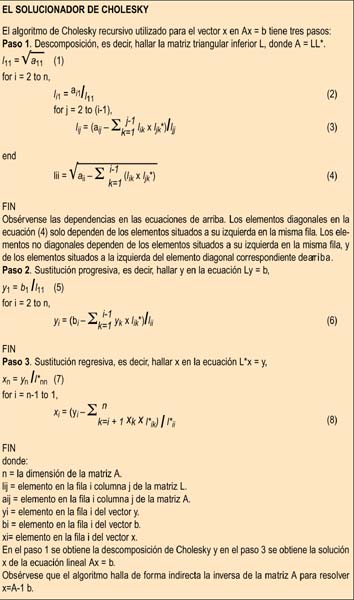
 Da die Eingangsmatrix hermitesch ist und die Zerlegung komplexe konjugiert-transponierte Dreiecksmatrizen erzeugt, wird die Speichernutzung optimiert, indem nur die untere Dreieckshälfte der Eingangsmatrix A geladen und bei der Generierung der unteren Dreiecksmatrix L überschrieben wird. Beide Teilsysteme sind pipeliniert und verwenden eine Eingabe- und eine Verarbeitungsstufe, um die Verarbeitung in einem Speicherbereich zu ermöglichen, während der andere zum Laden neuer Daten genutzt wird. Die Ausgabe der Zerlegungs- und Vorwärtssubstitutionsstufen wird der Eingabestufe der Rückwärtssubstitution zugeführt, wie in Abbildung 2 dargestellt.
Der Hauptteil der Zerlegung besteht aus dem komplexen Skalarproduktgenerator (auch Vektormultiplizierer genannt), der die Gleichungen (3) und (4) berechnet. Beim Stratix-V-Baustein wird eine Vektorgröße (VS) von bis zu 90 komplexen Datenelementen verwendet, beim Arria-V-Baustein hingegen eine Vektorgröße von bis zu 45. Die Vektorgröße entspricht der Anzahl der parallelen Speicherzugriffe, die erforderlich sind, um dem Skalarproduktgenerator für jeden Taktzyklus einen neuen Datensatz bereitzustellen, und bestimmt somit die Breite und Partitionierung des On-Chip-Dual-Port-Speichers. Aus Implementierungsgründen wird der Speicher eines Arrays gegebener Größe in (N/VS) Ceiling-Speicherbänke unterteilt, wobei Ceiling(VS) die Ceiling-Funktion und N die Arraygröße ist.
Der Cholesky-Solver ist mehrkanalig ausgelegt. Die maximale Anzahl der Kanäle ist ein Kompilierzeitparameter und wird nur durch den verfügbaren Speicher des Bausteins begrenzt. Die Speicherpartitionierung ist identisch mit der Einkanal-Implementierung, mit dem Unterschied, dass eine bestimmte Anzahl von Kopien derselben Struktur erstellt wird.
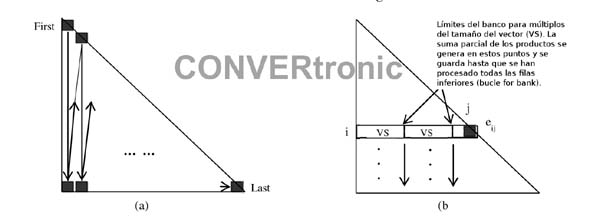
Die Zerlegung erfolgt elementweise und spaltenweise, beginnend in der oberen linken Ecke und vertikal in einem Zickzackmuster bis zur unteren rechten Ecke der Matrix (siehe Abbildung 3(a)). Zuerst wird das Diagonalelement jeder Spalte berechnet, gefolgt von allen Nicht-Diagonalelementen darunter in derselben Spalte, bevor mit dem Diagonalelement der nächsten Spalte rechts fortgefahren wird. Der Ablauf der Ereignisse und Iterationen wird durch eine verschachtelte vierstufige for-Schleife gesteuert. Die äußerste Schleife verarbeitet die Spalte, die zweite Schleife die Bank, die dritte innere Schleife die Zeilen und die innerste Schleife die verschiedenen Kanäle. Durch die Platzierung der Kanalverarbeitung als innerste Schleife wird der Gleitkomma-Akkumulator effektiv in einen Time-Sharing-Akkumulator umgewandelt und seine Latenz besser verborgen. Der NestedLoops-Block im DSP Builder Advanced Blockset integriert bis zu drei verschachtelte Schleifen in einen einzigen Verarbeitungsblock, was die Implementierung beschleunigt und die Ressourcennutzung im Vergleich zu einer ähnlichen Funktion, die als drei separate for-Schleifenblöcke implementiert ist, effizienter gestaltet. Der Block extrahiert komplexe Schleifensteuersignale, reduziert die Entwurfs- und Debugging-Zeit und macht die Schleifenstruktur lesbarer
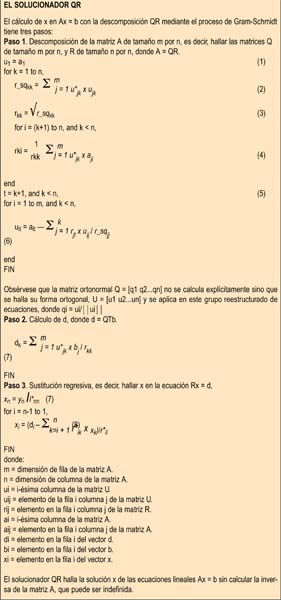 Der Skalarproduktgenerator verarbeitet die Zeilen der Matrix und berechnet Multiplikationen bis zur Größe des Vektors im Summenglied der Gleichungen (3), (4) und (6) gleichzeitig in einem einzigen Zyklus. Am Eingang des Skalarproduktgenerators wird in den Zeilenzyklen der mehrfachen Eingangsmatrizen eine zirkuläre Speicherstruktur verwendet.
Bei Skalarprodukten, die kürzer als die Vektorgröße sind, werden nicht verwendete Terme maskiert und nicht in die Summe einbezogen. Bei Skalarprodukten, die länger als die Vektorgröße sind, werden Teilsummen der Produkte berechnet und innerhalb der Bankgrenzen gespeichert, bis alle verfügbaren Bänke für ein gegebenes Element in der entsprechenden Zeile zu einer Endsumme summiert sind (siehe Abbildung 3(b)). Die Summation der Bankausgänge erfolgt in einer einzigen Akkumulatorschleife mithilfe des Gleitkomma-Addierers im DSP Builder Advanced Blockset. Die Rückkopplungsschleife hat eine Latenz von 13 Zyklen. Durch Vertauschen der Bank- und Zeilenschleife im Vergleich zu ihrer üblichen Software-Implementierungsreihenfolge und durch Hinzufügen von Mehrkanalverarbeitung wird die Latenz des Gleitkomma-Akkumulators kaschiert, wodurch die Hardwareauslastung verbessert wird.
Das DSP Builder Advanced Blockset berechnet automatisch Schleifenverzögerungen, um diese Latenz zu kompensieren. Das Tool kann so konfiguriert werden, dass die minimale Verzögerung berechnet und verwendet wird, indem das Kontrollkästchen „Minimale Verzögerung“ im Block „Schleifenverzögerung“ aktiviert wird. Pfaden, die identische Verzögerungen verursachen, kann eine Äquivalenzgruppennummer zugewiesen werden. Das Tool weist dann allen Mitgliedern der Gruppe denselben Verzögerungswert zu. Obwohl in den in diesem Artikel untersuchten Beispielen nicht verwendet, bietet das DSP Builder Advanced Blockset einen anwendungsspezifischen Gleitkomma-Akkumulator, dessen Geschwindigkeit und Ressourcenbedarf durch Konfiguration von Parametern wie der maximalen Eingangsgröße und der erforderlichen Akkumulationsgenauigkeit optimiert werden können. Dieser Block ermöglicht die Akkumulation eines einzelnen Gleitkommazahlenstroms mit hoher Taktfrequenz in einem Taktzyklus pro Abtastung.
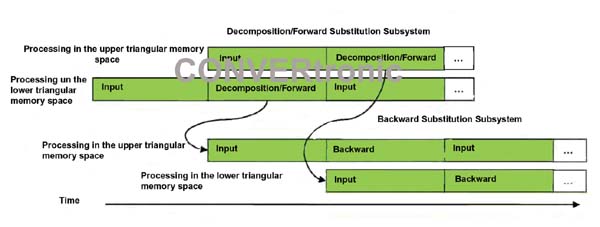 Das zweite Teilsystem führt die Rücksubstitution durch. Dieses Teilsystem verfügt über eigene Eingabe- und Ausgabespeicherblöcke. Wie das Cholesky-Vorwärtssubstitutions-Teilsystem ist es in eine Eingabe- und eine Verarbeitungsstufe unterteilt. Da die Komplexität der Rücksubstitution in der Größenordnung von N² liegt, verglichen mit N³ für die Zerlegung, wird für das Skalarprodukt keine Vektorverarbeitung verwendet. Stattdessen wird ein einziger komplexer Multiplikator für das Skalarprodukt verwendet, was ausreicht, um die Schritte der Cholesky-Zerlegung und des
 Vorwärtszerlegungs-Teilsystems durchzuführen.
Autor:
Vom Team von Berkeley Design Technology, Inc. Oktober 2012
(Fortsetzung im März)








