




 Anders als beim Cholesky-Verfahren, bei dem die Gleichungen (1) bis (6) als eine einzige verschachtelte Schleife vier Stufen implementiert sind, verwendet der QR-Solver einen einzigen endlichen Automaten (FSM), um die vier Hauptoperationen zu durchlaufen: das Quadrat der Länge eines Vektors in Gleichung (2), das Skalarprodukt zweier Vektoren in Gleichung (4), die Subtraktion des Skalarprodukts eines Vektors in Gleichung (6) und das Skalarprodukt in Gleichung (7) zur Bestimmung des Vektors d. Der NestedLoop-Block des DSP Builder Advanced Blocksets wird in allen Phasen des FSM verwendet, um alle Ereignissteuerungssignale für den Datenpfad zu generieren.
Der gemeinsame Verarbeitungsblock der vier oben genannten Operationen ist der Skalarproduktgenerator. Zur Leistungssteigerung wird die Berechnung des Skalarprodukts mittels Vektorverarbeitung durchgeführt. Ähnlich wie beim Cholesky-Design ist die Vektorgröße ein Kompilierzeitparameter. Um diesen Generator in den vier Zuständen des endlichen Automaten (FSM) wiederzuverwenden, wird am Eingang ein Datenmultiplexer eingesetzt, der vom Ereignishandler des FSM gesteuert wird. Der Multiplexer wählt in jedem FSM-Zustand die korrekten Eingänge für den Skalarproduktgenerator aus. Die Details des Skalarproduktgenerators und des Gleitkomma-Akkumulators entsprechen denen des Cholesky-Designs und werden daher hier nicht weiter erläutert.
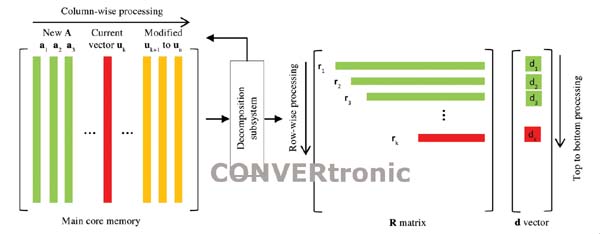
Der für die QR-Zerlegung benötigte Speicher wird optimiert, indem der Hauptspeicherblock des Kernels wiederverwendet wird, der anfänglich die Matrix A und den Eingangsvektor b enthält. Die Verarbeitung erfolgt spaltenweise von links nach rechts im Kernelspeicher. Sobald eine Spalte verarbeitet ist und nicht mehr benötigt wird, wird sie mit der entsprechenden Spalte einer neuen Matrix überschrieben. Wenn das alte Array A zerlegt wird, werden die ursprünglichen Inhalte dieses Speicherblocks durch ein neues Array ersetzt, wodurch die durchgängige Verarbeitungskapazität des Arrays ohne Unterbrechungen erhalten bleibt.
In den ersten beiden Zuständen des endlichen Automaten (FSM) werden die Elemente der Matrix R zeilenweise generiert, beginnend mit dem Diagonalelement jeder Zeile. Im Subtraktionszustand des FSM werden die Spalten der Matrix A im Hauptspeicher rekursiv aktualisiert und durch die teilweise berechneten Vektoren ersetzt. Beispielsweise werden in Spalte k alle Spalten k+1 bis n im Speicher aktualisiert, indem die skalierte Version von jeder der Spalten k+1 bis n subtrahiert wird. Dieser Prozess berechnet rekursiv die Vektoren uk+1 bis un und ist eine effizientere Version von Gleichung (6) für die Hardware-Implementierung. Im vierten Zustand des FSM, der spaltenorientiert arbeitet, wird jedes neu berechnete uk mit dem Eingangsvektor b multipliziert, um ein einzelnes Element dk des Spaltenvektors d zu erzeugen. Die Matrix Q wird nicht explizit generiert, aber ihre orthogonalen Spalten uk werden generiert und in späteren Phasen des FSM verwendet. Diese Spalten werden dann in der entsprechenden Spalte ak der neuen Matrix im nächsten FSM-Zyklus überschrieben. Abbildung 5 zeigt die Speicherorganisation und die Verarbeitungssequenz des QR-Zerlegungssubsystems.
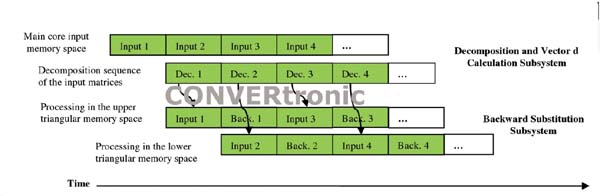
Die Ausgaben des ersten Teilsystems sind die Matrix R und der Spaltenvektor d. Die Matrix R ist eine obere Dreiecksmatrix und wird spaltenweise von links nach rechts generiert, wie in den Gleichungen (3) und (4) dargestellt. Es wird eine Ping-Pong-Dreiecksspeicherstruktur verwendet. Während der obere Dreiecksabschnitt im Rücksubstitutions-Teilsystem verarbeitet wird, wird der untere Dreiecksabschnitt vom Dekompositions-Teilsystem gefüllt und umgekehrt. Der Spaltenvektor d wird zur Matrix R addiert und spaltenweise von oben nach unten generiert. Die Ausgabe der Rücksubstitution ist der Lösungsvektor x der linearen Gleichungen Ax = b.
Der QR-Solver kann, ähnlich dem Cholesky-Solver, in einem Mehrkanalformat implementiert werden, um die Auslastung zu verbessern, die Latenz zu reduzieren und die Leistungsfähigkeit des Designs zu steigern. Die Leistungssteigerung beruht primär auf der effektiven Reduzierung der Latenz des Gleitkomma-Akkumulators.
3. Designablauf und
Evaluierungsmethodik
: Für diese Evaluierung stellte Altera BDTI Implementierungen der Cholesky- und QR-Solver zur Verfügung, die mit dem DSP Builder Advanced Blockset erstellt wurden. Die BDTI-Ingenieure erhielten von Altera einen PC mit vorinstallierten Altera-Tools und MathWorks. Anschließend untersuchten, simulierten und synthetisierten die BDTI-Ingenieure die Altera-Designs in der Simulink-Umgebung. Die synthetisierten Designs wurden dann auf zwei verschiedenen Geräten angewendet: den Stratix V und Arria V FPGAs. Während dieses Prozesses evaluierte BDTI den Designablauf von Altera und die Leistung der beiden Beispieldesigns.
Da die für diese Evaluierung verwendeten Karten die Stimuli für die Beispieldesigns nicht generieren konnten, enthält jedes Design einen Stimulusgenerierungsblock, der mit Blöcken des DSP Builder Advanced Blocksets implementiert und mit dem Design der zu testenden Anwendung kompiliert wurde. Um die Auswirkungen des Stimulusblocks auf die Leistung des Testdesigns und die FPGA-Ressourcennutzung zu minimieren, wird die Matrix A vom Stimulusblock dynamisch aus einem deutlich kleineren Satz von Zufallsdaten generiert. Dieser kleine Datensatz wird mithilfe von M-File-Skripten in MATLAB generiert, in den Speicher des Stimulusblocks geladen und mit dem Design kompiliert. Die MATLAB-Skripte verwenden denselben Algorithmus wie der Stimulusblock im Testdesign, um Gleitkomma-Referenzdaten doppelter Genauigkeit für den Lösungsvektor x zu generieren. Diese Daten dienen der Messung des Fehlerniveaus der in die FPGAs eingespeisten Simulink-Modelle und -Designs. Im Cholesky-Design garantiert dieser Algorithmus eine positive hermitesche Definition der Matrix A, während das Design mit dem QR-Solver die Erzeugung einer wohlkonditionierten Matrix A gewährleistet. Für das Cholesky-Solver-Design wurden vier Konfigurationen für Vektor-, Matrix- und Kanalgröße implementiert: drei auf dem Stratix V FPGA und zwei auf dem Arria V-Baustein, wobei eine Konfiguration beiden gemeinsam ist. Für das QR-Solver-Design wurden vier Konfigurationen auf dem Stratix V FPGA implementiert, zwei davon zusätzlich auf dem Arria V-Baustein. Alle Konfigurationen wurden hinsichtlich FPGA-Ressourcennutzung, maximaler Taktfrequenz, Leistung und funktionaler Korrektheit evaluiert. Die Designbeschränkungen des FPGA, wie Taktfrequenz, Geräteauswahl und Geschwindigkeitsstufe, werden in der Simulink-Umgebung festgelegt.
 Leistung und Fähigkeiten wurden sowohl auf Ebene des Simulink-Modells als auch der Hardwareplattform evaluiert. Das Simulink-Modell beider Designs wurde instrumentiert, um sowohl den Vorwärtsprozess als auch die Gesamtzahl der Vorwärts- und Rückwärtsverarbeitungszyklen zu visualisieren. Die Quartus II-Software lieferte die für jede Konfiguration erreichte maximale Frequenz (F<sub>max</sub>). Anschließend wurde jede Konfiguration auf die Hardwareplattform geladen, ihre Betriebsfrequenz auf F<sub>max</sub> eingestellt und der Prozess gestartet. Die Lösungsvektoren (x) jedes Solvers für jede Konfiguration wurden erfasst und mit den entsprechenden, in MATLAB generierten Gleitkomma-Referenzwerten doppelter Genauigkeit verglichen.
Das Skript nach der Simulation berechnet die Differenz zwischen der Simulink-IEEE-754-Gleitkommaausgabe (einfache Genauigkeit) und den in MATLAB generierten Gleitkomma-Referenzvektoren (doppelte Genauigkeit). Analog dazu berechnet das Skript die Differenz zwischen den Ergebnissen der Hardware-Simulationen und den in MATLAB generierten Gleitkomma-Referenzvektoren (doppelte Genauigkeit).
Die Evaluierung des Simulink-Toolkits
basiert auf der MATLAB-Umgebung und erfordert diese daher. In der Simulink-Umgebung verwenden die evaluierten Designs Blöcke aus dem DSP Builder Advanced Blockset, einem separaten Blockset der DSP Builder-Standardbibliothek. Das DSP Builder Advanced Blockset ist auf die blockbasierte Implementierung von DSP-Algorithmen und Datenpfaden ausgerichtet und verwendet eine höhere Abstraktionsebene als die DSP Builder-Standardbibliothek, welche allgemeinere und elementarere Blöcke umfasst. Die Bibliothek des DSP Builder Advanced Blockset enthält über 50 gängige trigonometrische, arithmetische und Boolesche Funktionen sowie komplexere Funktionsblöcke für die schnelle Fourier-Transformation (FFT) und FIR-Filter. Zu den bemerkenswerten Neuerungen in Quartus II Version 12.0 gehören die Blöcke für die latenzarme Quadratwurzelberechnung, verschachtelte for-Schleifen und anpassbare Gleitkomma-Akkumulatoren. Elemente des Standard Blocksets und des DSP Builder Advanced Blockset können nicht auf derselben Hierarchieebene in einer Datenpfadstruktur kombiniert werden; nur die Blöcke des DSP Builder Advanced Blockset unterstützen den Gleitkomma-Compiler. Die Blöcke im Standard-Blockset sind nicht für Gleitkommaverarbeitung optimiert. Zwar ist der Import von manuell codiertem HDL für das Standard-Blockset möglich, nicht jedoch für das DSP Builder Advanced-Blockset, da dieses Tool keine HDL-Implementierungen unterstützt. Generell eignet sich der blockbasierte Ansatz für die Eingabe gut für DSP-Algorithmen. Da jedoch Konstrukte wie `case` oder `switch` in der Blockbibliothek nicht verfügbar sind, ist ein textbasierter Ansatz für steuerungsintensive Designs und solche mit Zustandsautomaten intuitiver.
Die Simulation mit DSP Builder Advanced Blockset kompiliert das Simulink-Modell, generiert HDL-Code und Constraints für die Altera Quartus II Softwareumgebung, erstellt eine Testumgebung und Skriptdateien für ModelSim und simuliert das Simulink-Modell. Die Simulationszeiten für verschiedene Konfigurationen lagen je nach Arraygröße zwischen 3 und 28 Minuten (Intel Xeon W3550 PC). Die Simulink-Simulation liefert detaillierte Schätzungen der Ressourcennutzung, ohne dass die Quartus II Software kompiliert werden muss. Dies hilft dem Entwickler, die benötigte Bauteilgröße schnell zu bestimmen. Bei Verwendung eines Hardware-Entwicklungskits muss der Benutzer die Ausgangspinbelegung anhand des Platinenlayouts festlegen. Ausgangspin-Constraints können in der mitgelieferten .qsf-Datei im Quartus II Software-Projektordner angewendet oder die Ausgangspins von Anfang an über die Quartus II Software-Pinkonfiguration zugewiesen und verwaltet werden.
Am Modell wurden Tests durchgeführt, um die einfache Erforschbarkeit des Algorithmus und die Generierung des zugehörigen HDL-Codes zu evaluieren. Eingabeparameter wie die Größe des Skalarprodukts, die Matrixgröße und der Datentyp wurden im Stimulusblock und während der Simulationsausführung variiert. In allen Fällen wurde innerhalb weniger Minuten der korrekte RTL-Code generiert, und die Simulationsergebnisse stimmten mit der MATLAB-Referenz überein.
Alle Konfigurationen wurden mit der Designsoftware Quartus II erstellt, die direkt aus der Simulink-Umgebung gestartet werden kann. Entwickler können Quartus II im Push-Button-Modus mit Standard- oder benutzerdefinierten Optimierungsparametern nutzen oder den Design Space Explorer (DSE) verwenden. DSE, ein Bestandteil von Quartus II, führt automatisch mehrere Router-Durchläufe mit jeweils unterschiedlichen Startwerten durch. Der Router mit der besten Taktfrequenz wird gespeichert. Dieser automatisierte Prozess erfordert keine Benutzereingriffe, dauert aber deutlich länger als die Push-Button-Methode. Mit Quartus II dauerte dies je nach Designgröße zwischen einer und sechseinhalb Stunden.
Der hohe Abstraktionsgrad des DSP Builder Advanced Blockset-Designprozesses beschleunigt die Explorations- und Simulationszyklen des algorithmischen Raums und reduziert somit die Gesamtzeit bis zum optimierten Enddesign. Dieser Vorteil ist jedoch nicht inhärent in Simulink, wie beispielsweise die Datentyppropagation. Um die Vorteile der blockbasierten Designmethode gegenüber handgeschriebenem RTL bei der Designraumexploration zu nutzen, muss der Entwickler beim Erstellen des Simulink-Modells zusätzliche Schritte unternehmen. Das Modell muss insbesondere so strukturiert sein, dass die Exploration des algorithmischen Raums anhand von Parametern möglich ist. In den in diesem Artikel analysierten Beispielen wurden die Modelle so implementiert, dass Tests mit verschiedenen Matrix- und Vektorgrößen sowie (im Fall des Cholesky-Solvers) der Anzahl paralleler Kanäle möglich sind. Sobald ein Modell mit dieser Flexibilität erstellt ist, lassen sich Leistungs- und Ressourcennutzungsabschätzungen für verschiedene Designkonfigurationen durch Variation dieser Parameter durchführen. Um eine gute Leistung und Ressourcennutzung zu erzielen, ist es außerdem notwendig, das Hardware-Design zu verstehen, wie das Beispiel des in Abschnitt 2 dieses Artikels beschriebenen Gleitkomma-Akkumulators zeigt.
Die Schulung für den DSP Builder Advanced Blockset-Design-Workflow umfasst vier Stunden Vorlesungen von Altera sowie ca. zehn Stunden Online-Seminare und -Demonstrationen. Zusätzlich investierte BDTI ca. 90 Stunden in praktische Übungen, um das Tool und beide Modelle zu erlernen. Der Zeit- und Arbeitsaufwand für die Einarbeitung in das Toolkit hängt von den Fähigkeiten und Vorkenntnissen des Entwicklers ab.
Ingenieure mit Erfahrung in blockbasiertem Simulink-Design und Hardwareentwicklung werden die DSP Builder Advanced Blockset-basierte Methode wahrscheinlich als effizient und benutzerfreundlich empfinden. Für FPGA-Entwickler mit geringen oder keinen Kenntnissen in MATLAB und Simulink kann die Entwicklung auf einer höheren Abstraktionsebene eine neue Denkweise und somit eine anfängliche Herausforderung darstellen, die den Lernprozess beeinflussen kann. Nach der Einarbeitung in die Methodik lassen sich deutlich schnellere Entwicklungszyklen als mit HDL erzielen. Entwickler können sich auf die Implementierung des Algorithmus konzentrieren, ohne sich um Hardware-Designdetails wie die Segmentierung kümmern zu müssen. Die Entwicklungs- und Verifikationszeit wird erheblich reduziert, da die Simulation und die funktionale Verifikation größtenteils in der Simulink-Umgebung durchgeführt werden. Die RTL-Ausgabe des Simulink-Builds kann dann in der ModelSim-Software für eine vollständige Funktionssimulation ausgeführt werden.
Für Ingenieure mit Vorkenntnissen im Systemdesign und wenig bis gar keiner Erfahrung im Hardware-Design dürfte die Lernkurve flacher verlaufen. Obwohl das Toolkit Hardware-Kompilierung, -Synthese, -Routing und automatische Skriptgenerierung in die Simulink-Umgebung integriert und zahlreiche komplexe Designkonzepte wie Datensegmentierung und Signalvektorisierung abstrahiert, sind dennoch gewisse Hardwarekenntnisse für die Implementierung erforderlich.
(Fortsetzung im April)
Autor:
Vom Team von Berkeley Design Technology, Inc. Oktober 2012








