




 Poiché la matrice di input è hermitiana e la decomposizione genera matrici trasposte coniugate triangolari complesse, l'utilizzo della memoria è ottimizzato caricando solo la metà triangolare inferiore della matrice di input A e sovrascrivendola durante la generazione della matrice triangolare inferiore L. Entrambi i sottosistemi sono pipeled e utilizzano una fase di input e una fase di elaborazione per consentire l'elaborazione in un'area di memoria mentre l'altra metà viene utilizzata per caricare nuovi dati. L'output delle fasi di decomposizione e sostituzione in avanti va alla fase di input della sostituzione all'indietro, come mostrato in Figura 2.
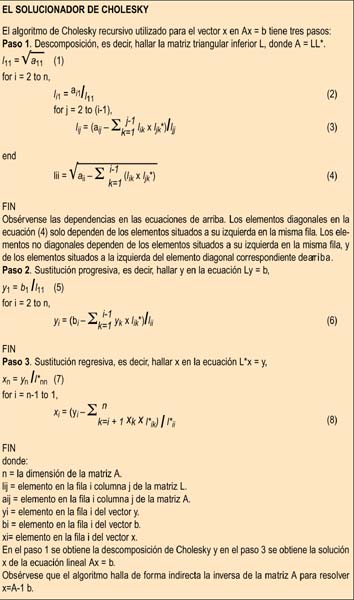
La parte principale della decomposizione consiste nel generatore di prodotto scalare complesso (chiamato anche moltiplicatore vettoriale), che calcola le equazioni (3) e (4). Per il dispositivo Stratix V, viene utilizzata una dimensione del vettore (VS) fino a 90 elementi dati complessi, mentre per il dispositivo Arria V viene implementata una dimensione del vettore fino a 45 elementi dati complessi. La dimensione del vettore corrisponde al numero di letture di memoria parallele necessarie per fornire al generatore di prodotto scalare un nuovo set di dati per ogni ciclo di clock e determina quindi la larghezza e il partizionamento della memoria a doppia porta on-chip. Per ragioni di implementazione, la memorizzazione di un array di una data dimensione è divisa in (N/VS) banchi di memoria a soffitto, dove soffitto (VS) è la funzione di arrotondamento per eccesso e N è la dimensione dell'array.
Il progetto del risolutore di Cholesky è multicanale. Il numero massimo di canali è un parametro di compilazione ed è limitato solo dalla memoria disponibile sul dispositivo. Il partizionamento della memoria è identico all'implementazione a canale singolo, con la differenza che viene creato un certo numero di copie della stessa struttura.
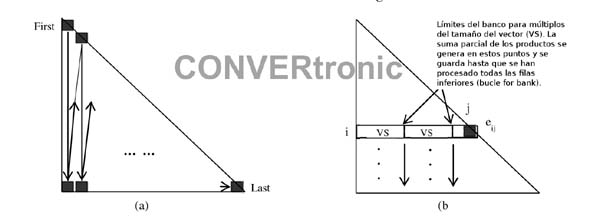
La decomposizione viene eseguita elemento per elemento, colonna per colonna, partendo dall'angolo in alto a sinistra e procedendo verticalmente con un andamento a zigzag, terminando nell'angolo in basso a destra della matrice, come mostrato in Figura 3(a). Innanzitutto, viene calcolato l'elemento diagonale di ciascuna colonna, seguito da tutti gli elementi non diagonali sottostanti nella stessa colonna, prima di passare all'elemento diagonale in cima alla colonna successiva a destra. La pianificazione degli eventi e delle iterazioni è controllata da un ciclo for annidato a quattro livelli. Il ciclo più esterno elabora la colonna; il secondo ciclo elabora il banco; il terzo ciclo interno elabora le righe; e il ciclo più interno elabora i diversi canali. Posizionando l'elaborazione dei canali come ciclo più interno, l'accumulatore a virgola mobile si trasforma di fatto in un accumulatore time-sharing, mascherando meglio la sua latenza. Il blocco NestedLoops in DSP Builder Advanced Blockset integra fino a tre cicli annidati in un singolo blocco di elaborazione, velocizzando l'implementazione e rendendo più efficiente l'utilizzo delle risorse rispetto a una funzione simile implementata come tre blocchi for separati. Il blocco estrae i complessi segnali di controllo del ciclo, riduce i tempi di progettazione e di debug e rende la struttura del ciclo più leggibile
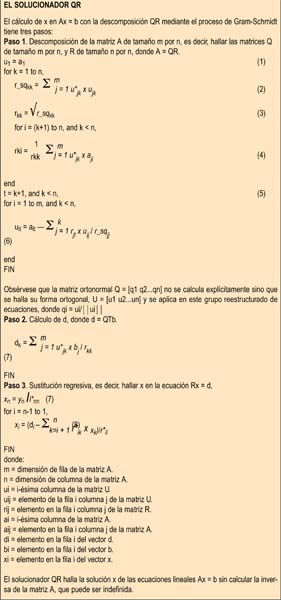 Il generatore di prodotto scalare lavora con le righe della matrice e calcola simultaneamente, in un singolo ciclo, moltiplicazioni fino alla dimensione del vettore nel termine di somma delle equazioni (3), (4) e (6). All'ingresso del generatore di prodotto scalare, nei cicli di riga delle matrici di input multiple, viene utilizzata una struttura di memoria circolare.
Per i prodotti scalari più corti della dimensione del vettore, i termini non utilizzati vengono mascherati e non inclusi nella somma. Per i prodotti scalari più lunghi della dimensione del vettore, le somme parziali dei prodotti vengono calcolate e memorizzate entro i limiti del banco fino a quando tutti i banchi disponibili per un dato elemento nella riga corrispondente non vengono sommati per ottenere una somma finale, come mostrato in Figura 3(b). La somma delle uscite dei banchi viene eseguita in un singolo ciclo di accumulazione utilizzando il blocco sommatore a virgola mobile nel DSP Builder Advanced Blockset. Il ciclo di feedback ha una latenza di 13 cicli. Scambiando il ciclo dei banchi e il ciclo delle righe rispetto al loro ordine di implementazione software tradizionale e aggiungendo l'elaborazione multicanale, la latenza dell'accumulatore a virgola mobile viene nascosta, migliorando l'utilizzo dell'hardware.
Il DSP Builder Advanced Blockset calcola automaticamente i ritardi del ciclo per compensare questa latenza. Lo strumento può essere configurato per calcolare e utilizzare il ritardo minimo selezionando la casella "Minimum delay" nel blocco "Loop Delay". Ai percorsi che causano ritardi identici può essere assegnato un numero di gruppo di equivalenza e lo strumento assegnerà quindi lo stesso valore di ritardo a tutti i membri del gruppo. Sebbene non utilizzato negli esempi valutati in questo articolo, il DSP Builder Advanced Blockset fornisce un accumulatore a virgola mobile specifico per l'applicazione che l'utente può personalizzare per ottimizzarne la velocità e i requisiti di risorse, configurando parametri quali la dimensione massima dell'input e la precisione di accumulazione richiesta. Questo blocco consente l'accumulazione di un singolo flusso di numeri a virgola mobile, con un ciclo per campione, ad un'elevata frequenza di clock.
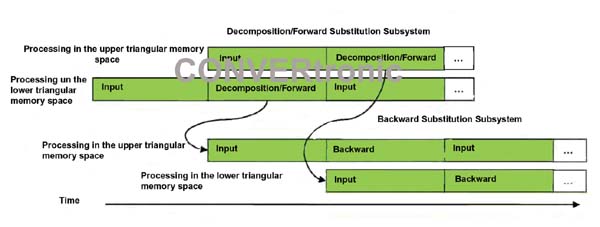 Il secondo sottosistema esegue la sostituzione all'indietro. Questo sottosistema ha i propri blocchi di memoria di input e output. Come il sottosistema di sostituzione in avanti di Cholesky, è segmentato in una fase di input e una fase di elaborazione. Poiché la complessità della sostituzione all'indietro è dell'ordine di N² rispetto a N³ per la decomposizione, non si utilizza l'elaborazione vettoriale per il prodotto scalare. Al suo posto, si utilizza un singolo moltiplicatore complesso per il prodotto scalare, che è sufficiente per seguire i passaggi della decomposizione di Cholesky e del
 sottosistema di decomposizione in avanti.
Autore:
A cura del team di Berkeley Design Technology, Inc. Ottobre 2012
(Continua a marzo)








